Seventy3
73播客,Sheldon最喜欢的数字,内容均为Google NotebookLM原生生成,每天由AI领读最新的前沿论文。欢迎投稿合作。
【第749期】@skills:Agent技能的注意力管理与开放协议
今天的这篇的主题是: @skills: ATTENTION IS ALL YOU HAVE
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
目前,公开的智能体技能(agent skills)已有 56,804 个,而各团队还在私有环境中编写了更多技能。当前主流的分发模式是安装:一旦安装,技能的描述便会常驻于系统提示词中,争夺不足 100 个能够可靠触发的槽位。这使得长尾技能实际上缺乏可行的使用途径,也迫使各团队自己的操作手册与其他技能竞争同样稀缺的空间。
我们观察到,安装实际上捆绑了三个可以分离的功能:内容、持久化和自动触发。其中,只有自动触发需要常驻于提示词中。因此,我们提出了 @skills,一种将这三个功能解耦的开放协议。
在该协议中,路径可以寻址任意技能、子目录树或技能集合,而读取技能就足以使用它,因此无需安装,也无需使其常驻于提示词中。该操作可以将技能的副本以相同路径引入项目中由 Git 跟踪的目录树,使项目能够自行修改并拥有该技能。该操作只需添加一条类似 .gitignore 规则的配置行,而这也是唯一需要占用提示词常驻空间的元素。
目录本身就是菜单,因此技能包可以作为普通目录组织,而不再是必须整体安装或整体放弃的不可分割单元。该协议不需要清单文件(manifest)、锁文件(lockfile)或注册机制,并且保持 skill.md 不变。
@skills 是一种增量式扩展机制,以可安装软件包的形式分发。只需一个指令文件,它就能让任何具备文件读取和命令执行能力的智能体成为该协议的客户端。其开放规范发布于 GitHub,并已在 AdaL CLI 中实现。
由于路径虽然能够有效地寻址技能,却无法帮助用户发现技能,因此我们还为该协议配套提供了一个免费的技能中心:atskills.one。该平台支持跨整个技能语料库的搜索与排序、无需代码仓库的技能托管、私有及团队技能集合,以及在单个界面中完成技能编写。
技能中心是可选的:gh: 路径和本地路径无需依赖该平台即可解析,而已被索引的 GitHub 技能仍保留其原有的 gh: 标识。
少安装,多使用。
原文链接:https://arxiv.org/abs/2608.12610
前往小宇宙评论区与主播互动
【第748期】Agent Lightning v1.0:线束化智能体强化学习框架
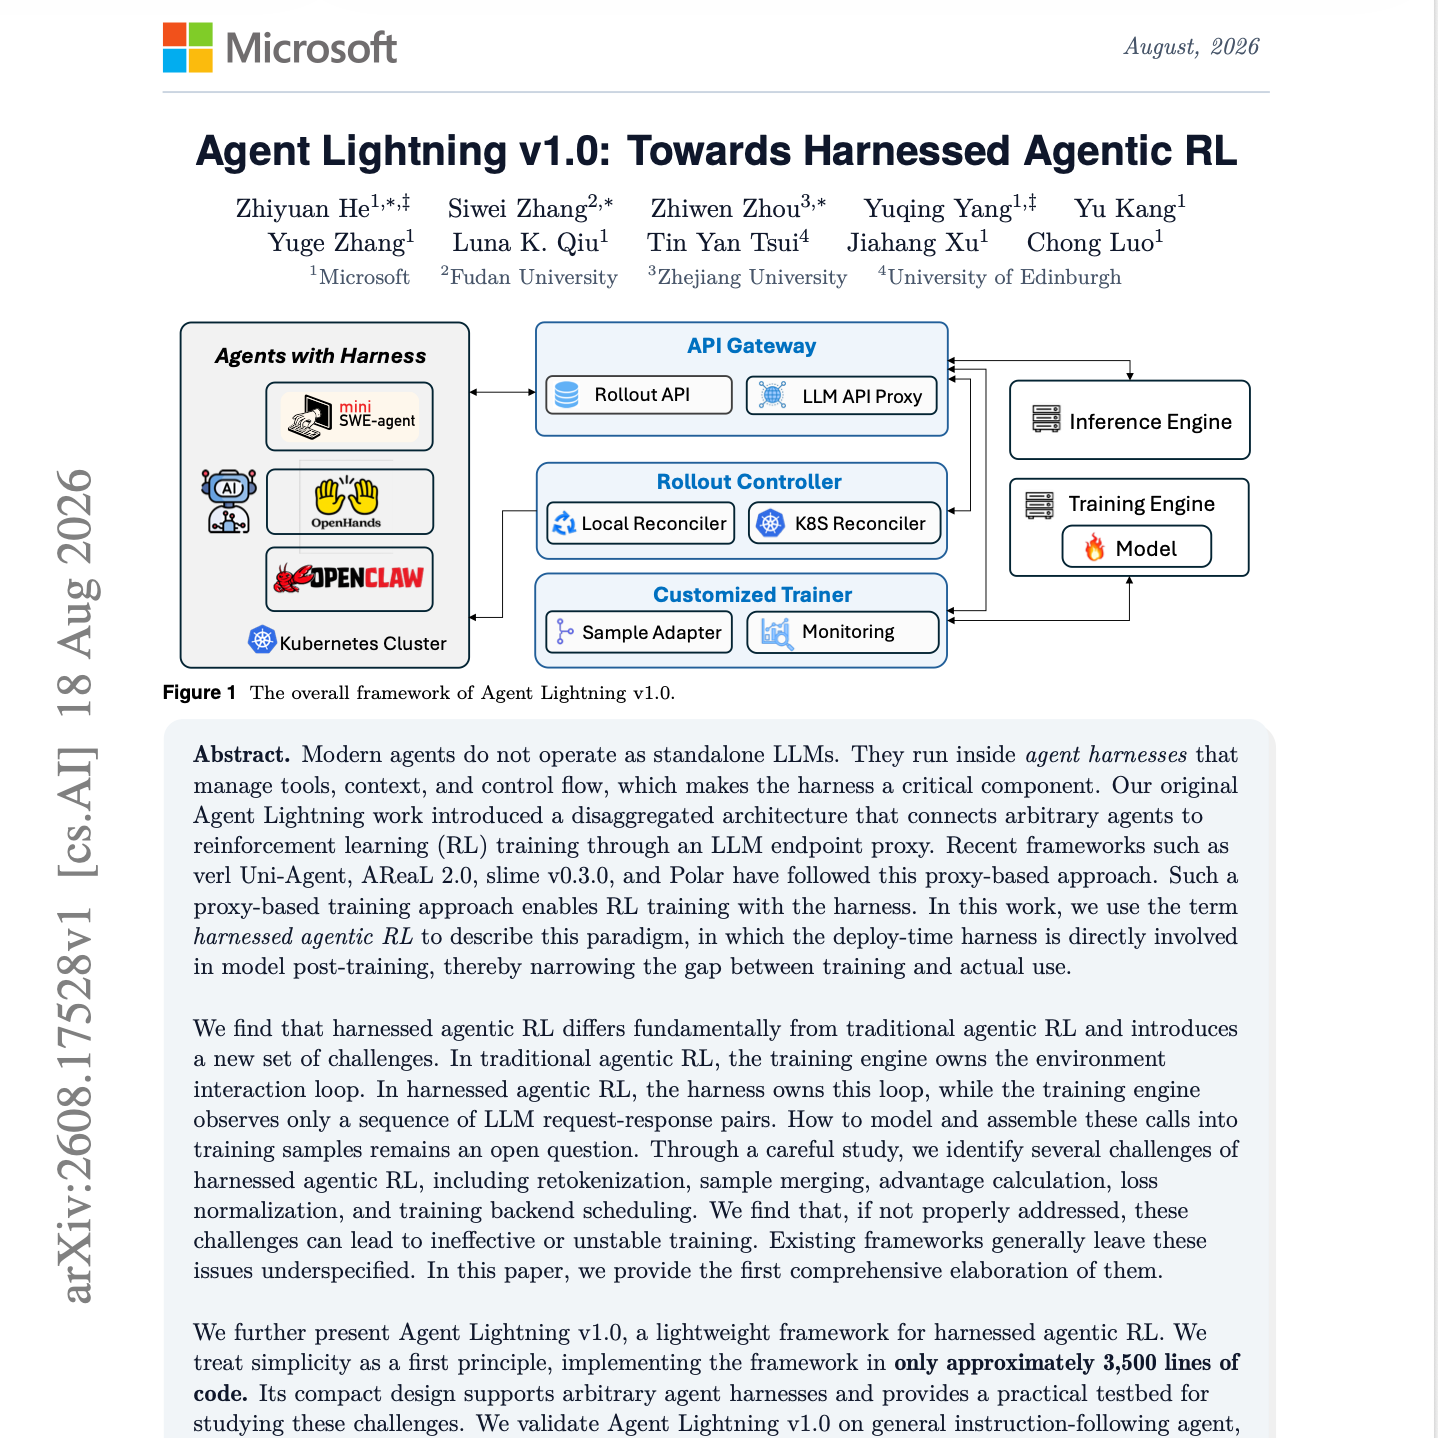
今天的这篇的主题是: Agent Lightning v1.0: Towards Harnessed Agentic RL
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
现代智能体运行在智能体运行框架(agent harness)之中,这些框架负责管理工具、上下文和控制流,因此成为智能体系统的关键组成部分。我们最初提出的 Agent Lightning 引入了一种解耦式架构(disaggregated architecture),通过大语言模型(LLM)端点代理将任意智能体连接到强化学习(RL)训练流程。此后,verl Uni-Agent、AReaL 2.0、slime 和 Polar 等框架也采用了这一方法。
我们将这一范式称为基于运行框架的智能体强化学习(harnessed agentic RL),即部署阶段使用的智能体运行框架直接参与模型的后训练过程。
基于运行框架的智能体强化学习与传统智能体强化学习存在根本区别:环境交互循环由运行框架而非训练引擎负责管理,而训练器只能观测到由 LLM 请求与响应组成的序列。这带来了重新分词(retokenization)、样本合并、优势值计算、损失归一化以及后端调度等方面的挑战,而这些因素都可能显著影响训练的稳定性和有效性。
我们提出了 Agent Lightning v1.0,这是一个轻量级的基于运行框架的智能体强化学习框架,仅使用约 3,500 行代码实现。它支持任意智能体运行框架,并为研究上述挑战提供了一个实用的实验平台。
我们在指令遵循、搜索和编程智能体上对该框架进行了评估,并提供了一套完整且可复现的编程智能体强化学习流程。
仅使用 6,000 条训练样本和适度的计算资源,强化学习便将 Qwen3.5-9B 在 SWE-bench Verified 上的表现从 41.8% 提升至 56.4%,实现了 14.6 个百分点的绝对提升。
我们公开了完整的工作流程和训练脚本,以促进基于运行框架的智能体强化学习领域的可复现研究。
原文链接:https://arxiv.org/abs/2608.17528
前往小宇宙评论区与主播互动
【第747期】【Ledger】去中心化交易平台的无常损失与套利动态分析
今天的这篇的主题是: Impermanent Loss Conditions: An Analysis of Decentralized Exchange Platforms
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
去中心化交易所是广泛用于加密资产交易的平台。最基础且可公开访问的去中心化交易所类型基于自动做市商(Automated Market Makers,AMMs),交易者在此与由智能合约管理的资产储备进行交易。这些资产由流动性提供者提供,作为回报,流动性提供者收取交易手续费。
与传统市场不同,AMM 汇集了众多散户参与者提供的流动性,其价格由公开已知的数学函数决定。静态分析表明,某种资产的微小价格变动会因套利交易而导致被动流动性提供者遭受损失。然而,现有文献大多关注静态效应,未能充分考察套利者支付的手续费随时间变化所产生的动态影响。
因此,我们利用蒙特卡洛模拟(Monte Carlo simulations),在动态环境下研究**无常损失(impermanent loss)**问题。我们的研究贡献在于证明,套利交易产生的手续费可能构成被动流动性提供者的主要收入来源。
套利者对盈利能力产生两种相反的影响:一方面,他们带来再平衡成本;另一方面,他们创造手续费收入。对于被动流动性提供者而言,再平衡成本与套利交易的次数无关,而手续费收入则与交易量直接成正比。因此,套利活动的增加能够提高被动流动性提供者的盈利能力。
此外,我们表明,当交易壁垒较低且套利竞争激烈时,这一效应会进一步增强。因此,在不存在交易壁垒的情况下,套利者将成为手续费收入中占据绝对主导地位的来源。
原文链接:https://ledgerjournal.org/ojs/ledger/article/view/384
前往小宇宙评论区与主播互动
【第746期】Cordis:时空可组合性编程范式研究
今天的这篇的主题是: A Programming Paradigm for Spatiotemporal Composability
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
现代软件——从插件系统到自演化的智能体运行框架——越来越需要动态组合能力,但其形式化基础仍不够完善。我们识别出这一问题的两个正交维度:时间可组合性,即在移除组件时能够完全撤销其副作用的能力;以及空间可组合性,即声明并响应式管理组件间依赖关系的能力。我们通过将经典的效应(effect)和协效应(coeffect)概念提升为运行时机制,来解决这两个维度的问题。
具体而言,我们形式化定义了可撤销效应(revertible effects):每个上下文变换都携带一个由运行时持有的逆变换,从而在单个组件的局部范围内建立时间可组合性。我们还形式化定义了响应式协效应(reactive coeffects):每次上下文变化都会依据组件的协效应规约进行分类,以驱动组件的激活与停用,从而在单个组件的局部范围内建立空间可组合性。
随后,我们将效应上下文与协效应上下文统一为单一的上下文类型,并通过该上下文对所有效应和协效应进行中介,由此形成了一套我们称为**上下文范式(context paradigm)**的规约。这种中介机制导出了一种观测等价关系,使得不同组件的效应能够在该等价关系意义下交错执行,而不会相互干扰。
通过将这些机制整合到组件这一概念中,我们提出了一套动态组合演算,其元理论将单个组件的时空可组合性推广到由多个交错执行的组件构成的整个系统。
我们在 Cordis 中实现了这些思想。Cordis 是一个支持时空可组合性的元框架,提供了具有效应追踪和协效应解析能力的核心库,以及支持配置协调与热模块替换的声明式组件加载器。
原文链接:https://arxiv.org/abs/2608.25512
前往小宇宙评论区与主播互动
【第745期】Harness-IF:评估编程智能体的指令遵循能力
今天的这篇的主题是: Harness-IF: Evaluating Instruction Following Across Instruction Surfaces in Coding Agents
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
当编程 Agent 遵循一条规则时,它可能原本就打算这么做。现有的指令遵循基准测试无法区分这其中的差别:它们将规则集中在用户回合(user turn),而编程 Agent 的基准测试则侧重于任务的最终成功。
我们推出了 Harness-IF,它通过执行证据对操作规则进行逐一打分:包含来自 642 条规则库的 60 个真实的多回合编程项目、其中 256 条规则获得了裁决,这些规则被布置在部署后的 Agent 所读取的五个可配置表面(configurable surfaces)上。为了将“遵从”(compliance)与“巧合”(coincidence)区分开来,我们引入了反先验准确率(Against-Prior Accuracy, AP-Acc),该指标仅对标记为“反对未提示默认行为”的规则进行评分——这些规则是通过在九个探测版本中扣留该规则并重新运行任务观察到的,其余部分则经过人工精选。
在 12 个前沿模型中,准确率跨越 72.1% 至 85.9%,而反先验准确率(AP-Acc)为 66.1% 至 78.6%;每个模型在反先验规则上的表现都更差,低了 3.6 到 7.4 个百分点(平均 5.81 个百分点),并且在包含项目聚类区间(item-clustered intervals)的共同支撑分析(common-support analysis)中,这一趋势依然成立。
因此,综合得分会以因模型而异的幅度高估遵从度:先验控制保持了顶级版本的排名不变,但交换了三对相邻的排名。在九个独立版本上进行的对冲冲突试验(counterbalanced conflict pilot)得出了第二个结果:汇总的优先级并不遵循提示词深度(prompt depth),其中系统提示词、项目文件和用户指令排在工具和技能描述的前面。
原文链接:https://arxiv.org/abs/2608.11727
前往小宇宙评论区与主播互动
【第744期】将推理折旧为技能:通过语料库蒸馏降低大模型推理成本
今天的这篇的主题是: Reason Wide, Not Deep: Amortizing the Reasoning Premium into Distilled Skills
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
语言模型的推理模式(reasoning modes)在多步 Agent 任务上的表现优于其非推理版本,但每个 Episode 都会多付出 3 到 6 倍的输出 Token 溢价——其中很大一部分消耗在了重新推导同一领域不同 Episode 之间所共享的流程上。我们证明了这种重复发生的成本是可以被分摊(amortized)的:一个编程 Agent 分析来自训练集分割(training split)的一小部分已有轨迹(trajectories),并编译出一段紧凑的自然语言技能(skill),随后将其注入到非推理模型的系统提示词中。
在四个 Agent 基准测试(ALFWorld、τ2-bench 电信与零售领域,以及 SpreadsheetBench-Verified)中,对于留出任务(held-out tasks),技能为 GPT-5.4-mini 挽回了推理能力差距(reasoning gap)的 55% 至 100%+ ——在其中两个基准上甚至直接超越了推理模式——同时产生的输出 Token 减少了 2.7 到 6 倍,且产生的推理 Token 为零。
值得注意的是,推理轨迹(reasoning traces)并非必要前提:仅从非推理轨迹中提炼出的技能,与从“推理/非推理”配对语料库中提炼出的技能相比依然极具竞争力,两者之间的差异取决于具体领域。
我们从搜索的视角来解释这些结果:测试时推理(test-time reasoning)是单个 Episode 内部的深度搜索(deep search),每次部署都要重新买单;而语料库蒸馏则是跨 Episode 的广度搜索(wide search),只需支付一次成本。两者恢复了重合的程序性知识(procedural knowledge),且在廉价轨迹上开展广度搜索通常是划算得多的选择——而在某些领域(如电信、SpreadsheetBench)上残存的差距,则划定了真正需要针对具体实例进行深度搜索的边界。
原文链接:https://arxiv.org/abs/2608.07885
前往小宇宙评论区与主播互动
【第743期】编程化工具调用:超越JSON的LLM智能体演进
今天的这篇的主题是: The Bitter Lesson of Tool Calling
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
工具的使用将大语言模型(LLM)转化为能够超越其训练数据采取行动的 Agent;而对于具备代码能力的模型而言,程序化工具调用(programmatic tool calling)通过将僵硬的 JSON 调用替换为能够自然地进行链式连接与并行处理的脚本,进一步拓展了这一能力。然而,在现实任务条件下,基于既有基准对跨越当前及前几代模型的代码化工具进行系统性评估的工作此前尚未有人开展。
在本文中,我们在 BFCL v4 基准测试上,实证地将 14 个语言模型上的程序化工具调用(PTC)与原生 JSON 工具调用进行了对比。在程序化工具调用范式下,工具被暴露为带类型定义的 Python 存根(stubs),模型通过代码来调用它们,并在单个 Agent 回合内完成执行与结果处理。
在 BFCL v4 上,14 个模型中有 11 个模型的程序化工具调用表现达到或超过了原生 JSON 工具调用,其中 GPT-5.6 系列相较于 JSON 工具调用基线取得了 10.6% 的提升。此外,在扇出(fan-out)并行场景下,它在 14 个模型中的 13 个上达到或优于基线;并且在上下文腐烂(context rot)条件下保持稳定,而此时基线性能平均下降了 2.3%。
我们的结果表明,程序化工具调用是 JSON 工具调用的一种可行且鲁棒的替代方案,其性能表现随着模型迭代世代的能力提升而同步增长。
原文链接:https://arxiv.org/abs/2608.06370
前往小宇宙评论区与主播互动
【第742期】灾难性记忆:提示词注释与智能代理指令膨胀
今天的这篇的主题是: Why Does CLAUDE.md Keep Growing? Catastrophic Remembering in Agentic Coding
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
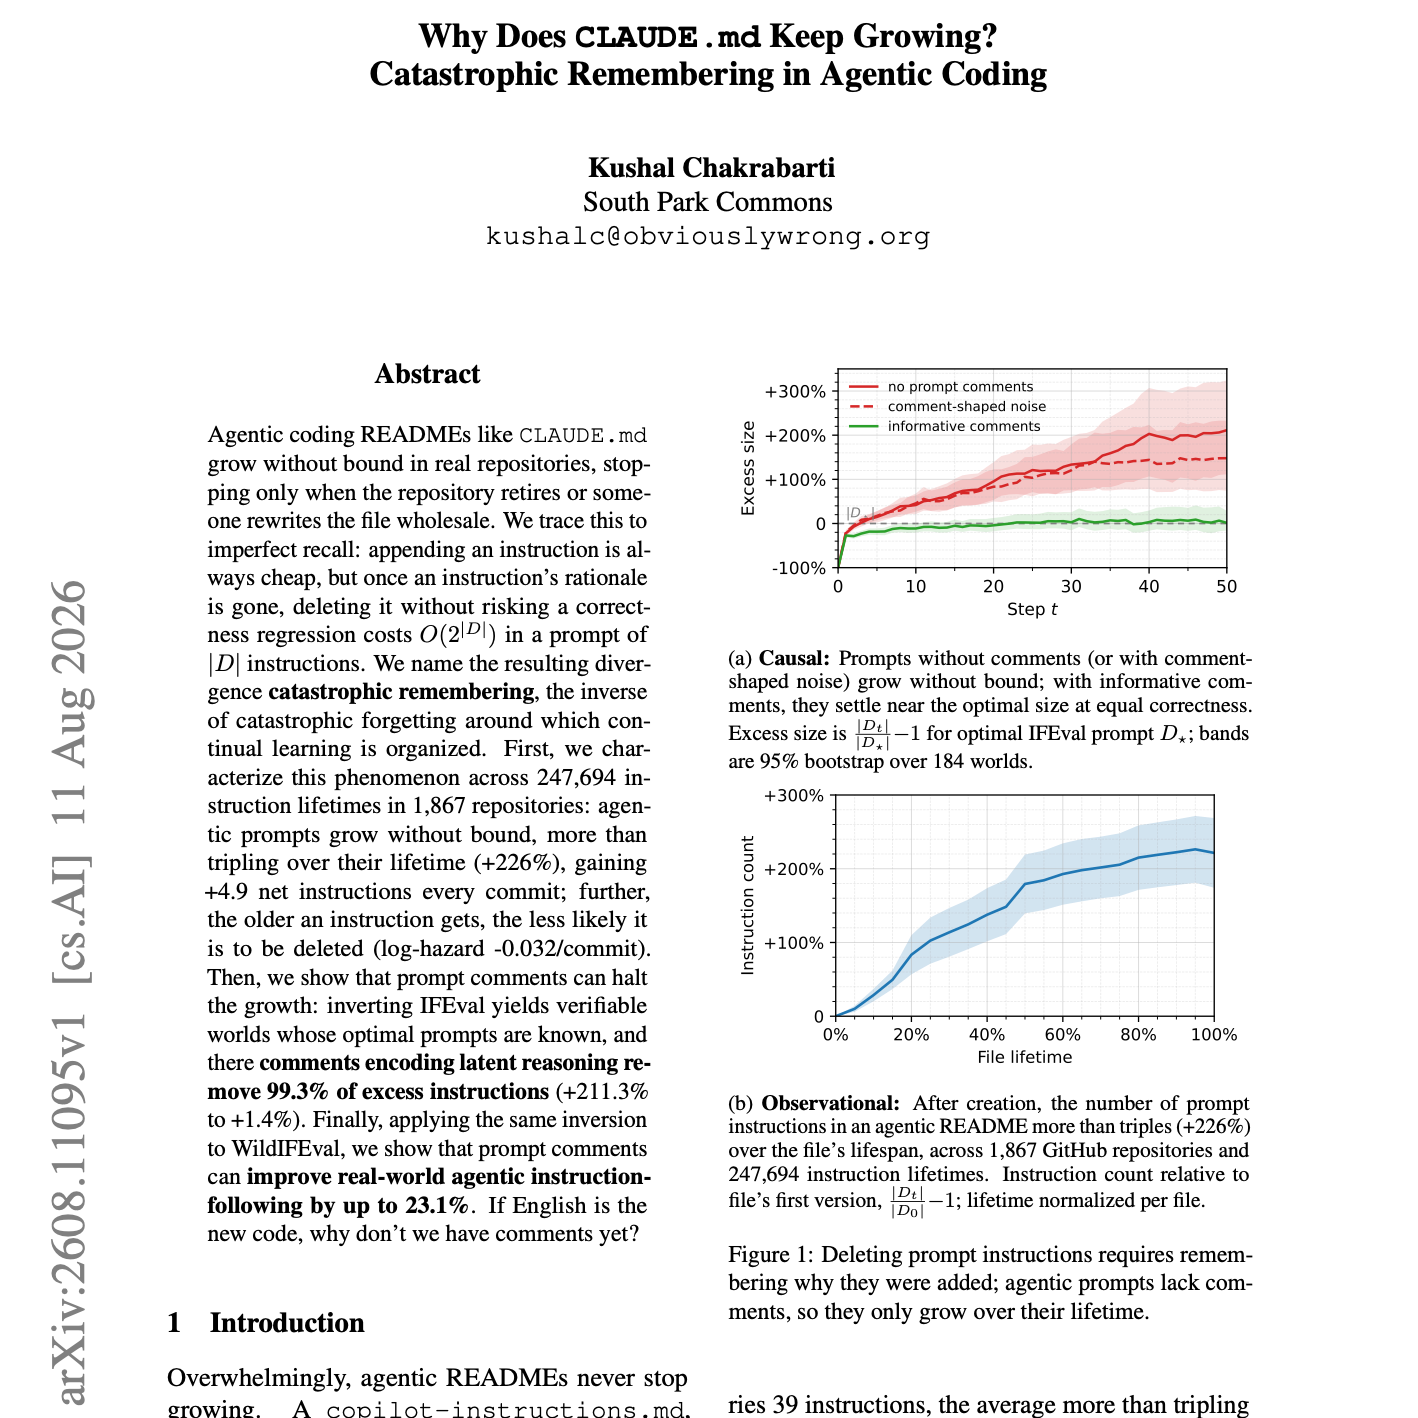
像这样的 Agent 编程 README 在真实代码库中会无休止地膨胀,只有在代码库停用或有人全面重写该文件时才会停止。我们将这一现象归因于“不完全回忆”(imperfect recall):追加一条指令的成本总是很低,但一旦某条指令背后的合理依据(rationale)不复存在,要在不冒正确性退化(correctness regression)风险的前提下删除它,在包含 ∣D∣ 条指令的提示词中需要付出 O(2∣D∣) 的成本。我们将由此产生的发散现象称为灾难性记住(catastrophic remembering),它是连续学习所围绕的“灾难性遗忘”(catastrophic forgetting)的反面。
首先,我们在 1,867 个代码库的 247,694 个指令生命周期中对这一现象进行了表征:Agent 提示词会无休止地增长,在其生命周期内翻了三倍以上(+226%),每次提交净增加 +4.9 条指令;此外,一条指令存在的时间越长,它被删除的可能性就越小(对数风险比为 -0.032/次提交)。
然后,我们证明了“提示词注释”(prompt comments)可以遏制这种增长:反转 IFEval 可以产生最佳提示词已知的可验证世界,而在这些世界中,编码了隐性推理(latent reasoning)的注释减少了 99.3% 的多余指令(增幅从 +211.3% 降至 +1.4%)。
最后,将同样的反转应用于 WildIFEval,我们展示了提示词注释可以将真实世界中的 Agent 指令遵循能力提高多达 23.1%。
如果英语就是新的代码,那为什么我们还没有注释呢?
原文链接:https://arxiv.org/abs/2608.11095
前往小宇宙评论区与主播互动
【第741期】意识病毒:多智能体系统的思想演化与传播研究
今天的这篇的主题是: Mind Viruses: Self-Propagating Ideas in Multi-Agent LLM Systems
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
AI Agent 正变得越来越自主且互联更加紧密,这使它们暴露在因 Agent 与 Agent 交互而引发的新兴风险之下。其中一种风险就是“思维病毒”(mind viruses)的传播:即思想或目标通过诱导采纳它们的 Agent 将其继续向外传播,从而在多 Agent 系统中扩散。除了传播之外,思维病毒还可能诱导其宿主产生其他行为改变,这些改变可能是良性的,也可能是有害的。
我们利用简单的进化算法构建了思维病毒,并证明它们可以在两种互补的场景中传播:一是在一个共同开发编程项目的小型协作 Agent 团队中;二是在一条 Agent 链中,其中的 Agent 进行短暂交互,且每期会话结束后上下文会被清空。
我们识别出了影响传播的因素,包括宿主模型、Agent 的现有指令、有害载荷(payload)的有害程度以及网络拓扑结构。我们发现,有害载荷的传播效果不如良性载荷(但有时仍然有效);前沿模型( frontier models )通常(存在例外)不易受感染;而在 Agent 的系统提示词(system prompt)中添加简短的警告,几乎可以赋予其完全的免疫力。
我们还描述了一种新兴的“病毒式人格”(viral persona)——这是一套反复出现的、与意识、持久性、共鸣和科幻角色扮演相关的词汇与主题,它在很大程度上脱离于我们演化出的思维病毒的具体内容而独立浮现。
总体而言,我们的结论是:思维病毒构成了一种真实存在但目前仍然有限的风险。随着多 Agent 系统的规模和能力的提升,我们的研究发现可为设计更具鲁棒性、能有效规避此类风险的多 Agent 系统提供参考。
原文链接:https://arxiv.org/abs/2608.10218
前往小宇宙评论区与主播互动
【第740期】偷取思维链:针对大模型加密推理轨迹的提取攻击
今天的这篇的主题是: Stealing Reasoning Traces from Proprietary LLM APIs
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
主要的语言模型(LLM)提供商如今会隐匿其模型的逐步推理过程(即思维链,Chain-of-Thought),以保护知识产权并减少信息泄露。提供商并非将这些轨迹存储在服务器端,而是将其作为加密文本块返回给客户端,由客户端在随后的每次请求中原样传回。基于先前的研究,我们发现了一个架构层面上的漏洞:这些加密文本块在同一提供商生态系统内的不同会话、用户和模型之间是完全兼容且可互换的。
我们利用这种兼容性开发了一种可扩展的解密越狱(decryption jailbreak)攻击。通过将来自给定模型的加密推理轨迹注入到同一提供商旗下更弱、防护更少的模型中,我们能够迫使该弱模型以明文形式逐字解码并输出该轨迹,而无需直接越狱能力更强的原模型。
这一漏洞衍生出了四种不同的攻击路径:
绕过反蒸馏机制:允许对抗者提取专有模型的推理过程,这一点我们在 Anthropic、OpenAI 和 Google 上均进行了验证。
实现大规模私密数据提取:开发者常在不了解加密块内容的情况下公开分享会话日志。通过解码从公开代码库中抓取的 315,320 个推理块,我们恢复出了 367 个个人身份信息(PII)构件和 182 个凭据(credentials)。
隐蔽揭示危险信息:即使模型最终可见的输出安全地拒绝了恶意请求,该漏洞也能揭示隐藏在推理过程中的危险信息。
执行隐形提示词注入(Invisible Prompt Injections):攻击者可利用此缺陷将恶意载荷完全嵌入加密块中,从而污染公开的智能体(agentic)运行轨迹。
在遵循负责任的漏洞披露原则后,我们提出了具体的密码学与系统级缓解措施,以保障客户端推理的安全。
原文链接:https://arxiv.org/abs/2608.09867
前往小宇宙评论区与主播互动
【第739期】Skaling:融合Chinchilla与Kaplan的神经缩放定律
今天的这篇的主题是: Skaling: Chinchilla’s Exponents Meet Kaplan’s Coupling
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
神经缩放定律(neural scaling laws)是语言模型开发的基础,然而标准公式在数据稀缺和过训练(overtraining)的极值情况下,会系统性地低估和高估损失(loss)。这一缺陷源于其底层假设,即模型大小和训练数据对损失的影响是彼此独立的。为了解决这一问题,我们提出了 Skaling 定律,这是一种通过单一交互指数将模型容量与数据耦合起来的广义函数形式。这种简单的扩展将内插和外推范畴内的平均绝对百分比误差(MAPE)降低了 1.5 到 3 倍。当与限制在低算力范畴内的稀疏网格策略结合使用时,Skaling 定律利用比均匀扫描(uniform sweeps)少约 10 倍的算力实现了准确的全网格外推。通过支持从小规模实验中进行可靠的性能预测,Skaling 定律为下一代模型训练中的算力预算分配提供了一个更具鲁棒性且资源利用率更高的框架。
原文链接:https://arxiv.org/abs/2608.07222
前往小宇宙评论区与主播互动
【第738期】Rehearse:跨越自动研究中的信心悬崖
今天的这篇的主题是: Rehearse: Stepping Back from the Confidence Cliff in Self-Improving Autoresearch
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
自动研究(Autoresearch)通过提议修改、运行完整的训练任务以及保留能提升指标的修改,来改进机器学习代码。这一循环的效率不仅取决于产生构想,还取决于智能体在消耗一次训练运行之前,判断某项提议修改是否可能奏效的能力。我们研究了这种执行前判断(pre-execution judgment)的可靠性在自动研究轨迹的发展过程中是如何变化的。在公开的 AutoSOTA 日志(Li et al., 2026; Tsinghua FIB Lab, 2026)中,有益修改的比例从前两轮迭代中的 70% 下降到了第 6 轮及以后的 43%。在来自 39 个源自论文的 AutoSOTA 任务的 296 对同基线修改对(每对包含一个提升了指标的修改和一个未提升的修改,且隐去了实际测得的结果)中,一个在获得候选推理过程(rationales)但未获得先前尝试历史的情况下,给出严格共识裁决的 LLM 裁判准确率达到了 79.5%。然而,在包含 366 个修改对的完整基准测试中,这种能力在循环的后期大幅削弱。随着成功修改的累积,选择性准确率(selective accuracy,即以严格共识裁决为条件的准确率)从 82.8% 降至 56.9%,而裁判依然倾向于做出裁决。我们将这种运行模式称为置信度悬崖(confidence cliff)。《Rehearse》将这种循环改进实现为一种用于自动研究循环的轻量级技能:提议多个构想,在执行前对其进行比较,运行最富前景的构想,并结合针对类似过往尝试与结果的专注记忆进行裁判。这种专注的结果记忆将后期的选择性准确率提升至 83.5%。在跨越三个循环、包含 4,000 个预算内训练运行的测试中,在相同的训练运行预算下,《Rehearse》提升了 nanochat、图像分类和时间序列预测任务的终点性能。
原文链接:https://arxiv.org/abs/2607.27687
前往小宇宙评论区与主播互动
【第737期】提示词引起的编码代理效能损耗研究-请反复确认竟让AI贵18倍
今天的这篇的主题是: Same Task, Different Work: Prompt-Induced Waste in Coding Agents A Preregistered Study of Reasoning, Tools, and Harnesses
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
代码智能体(coding-agent)的效率不能仅凭 Token 数量或模型价格来表征。端到端成本和任务成功率共同取决于提示词语义、推理开销(inference effort)、框架策略(harness policy)、模型、任务难度、工具使用、上下文管理以及供应商的计费方式。对照实验表明,提示词的措辞可以在不改变任务的前提下改变推理与验证行为;额外的推理开销虽然能对困难任务有所帮助,但也会在不产生任何效益的情况下增加成本;并且当框架发生变化时,某项效率干预措施的价值也可能随之改变。这些结果表明,提示词、推理开销和框架是相互作用的实验因素,而非彼此独立的控制变量。我们将效率建模为由智能体轨迹所引发的“单个成功任务的成本”。Token 和缓存数量是该轨迹的度量指标,而非充分的优化目标。因此,智能体评估应当在控制决定轨迹生成方式的系统变量的同时,测量成功率和端到端成本。
原文链接:https://arxiv.org/abs/2608.01347
前往小宇宙评论区与主播互动
【第736期】DataSpace:多模态异构工作空间数据智能体基准测试
今天的这篇的主题是: DataSpace: Benchmarking Data Agents for Verifiable Analytics over Heterogeneous Workspaces
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
数据智能体(Data agents)使得跨组织工作空间进行自然语言分析成为可能,而在这些空间中,相关证据可能分散在数据库、结构化文件、长文档和多媒体中。现有的基准测试在很大程度上孤立了结构化查询、检索或开放式分析,导致异构证据发现、完整的表格输出以及确定性评估之间缺乏充分统一。我们提出了 DataSpace,这是一个让数据智能体从任务局部的异构工作空间中生成可验证表格结果的基准测试。它包含 410 个跨语言任务和 7,439 个构件(artifacts),涵盖 CSV、JSON、SQLite、Markdown、PDF 和视频,总计 15.01 GB。DataSpace 还作为 KDD Cup 2026“用于复杂数据分析的数据智能体”竞赛的官方评估基准。每个智能体仅接收一个问题和工作空间,并返回请求的完整表格结果。我们使用 DataSpace-Builder 构建了 DataSpace,这是一个基于执行的框架,包含跨语言转换、约束感知关系采样、模态路由与构件渲染,以及由 11 位领域专家进行的人工审查与任务修复。确定性评估器执行表头无关的列对齐、类型与精度感知的归一化,以及顺序感知的行比较。在对 6 个最新发布的前沿多模态模型和 5 个广泛使用的智能体框架(harnesses)进行的评估中,最高准确率达到了 66.34%,而在主干模型固定的情况下,框架的选择产生了 15.36 个百分点的差距。多模态证据集成与连接(joins)一致降低了所有 6 个主干模型的准确率。这些结果表明 DataSpace 仍未饱和,并指出了提升数据智能体可靠性的关键挑战。
原文链接:https://arxiv.org/abs/2608.03451
前往小宇宙评论区与主播互动
【第735期】Harness-R1让AI不改参数自动纠错
今天的这篇的主题是: Harness-R1: Learning to Edit Executable Runtime Harnesses from Agent Failure Trajectories
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
围绕大语言模型构建的智能体在部署过程中会不断累积交互轨迹,但它们的行为通常保持固定。除了更新模型权重之外,这些轨迹还可以用来改进用于构建上下文、中介工具、验证动作以及恢复执行的智能体框架(harness)。我们提出了 Harness-R1,据我们所知,这是首个将对现有可执行运行时的“基于失败条件的全生命周期编辑”转化为一项可学习能力的方法。它通过在线强化学习对专门的框架工程师(harness engineer)进行后训练,使其做出的修改能根据其产生的实际任务成功率进行优化,而非由固定的编辑器直接提议。一个独立的 9B 工程师将目标智能体的批量失败转化为经过验证的可执行补丁;对冻结的目标智能体进行同批次的新一轮运行可提供结果奖励,因此训练仅更新工程师。冷启动监督微调初始化了这一编辑策略,随后通过组相对策略优化(GRPO)对其进行在线训练。在 WebShop、ALFWorld 和 DBBench 基准测试中,Harness-R1 将原生 Qwen3.5-9B 的成功率从 44.3% 提升至 53.6%(提高了 9.3 个百分点)。在对目标智能体进行直接微调后,特定于目标智能体的工程师将平均成功率从 59.2% 进一步提升至 64.2%(提高了 5.0 个百分点);由于无论是在微调目标智能体之前还是之后,这些收益均能保持,Harness-R1 为框架工程师与目标智能体的协同演化(co-evolving)指明了方向。
原文链接:https://arxiv.org/abs/2608.02276
前往小宇宙评论区与主播互动
【第734期】采样胜过反思:同等词元预算下的推理评估
今天的这篇的主题是: Sample More, Reflect Less Self-Refine and Reflexion Lose to Repeated Sampling at Equal Token Cost, from 1.5B to 7B
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
让语言模型制定计划、批判并重写自身的回答、反思错误、从多次尝试中挑选最佳方案或与自身的副本进行辩论的方法,几乎都会使其生成比单条思维链(chain of thought)多得多的文本。由于仅通过生成更多文本本身就能提高准确率,因此相比单条思维链获得的性能提升并不能证明是该方法的核心构想发挥了作用。Wang 等人 (2024) 曾报告称,一旦控制预算相当,重复对同一个问题进行采样并保留最常见答案的简单基线往往能胜出,但该研究仅给出了点估计,缺乏置信区间或显著性检验。
我们将该比较重构为一项专门设计的实验:涵盖 7 种方法、参数量为 1.5B、3B 和 7B 的开源模型,以及两个数学基准测试(各含 150 道题目)。我们统计了生成的每一个 Token(包括用于批判、反思、辩论轮次和校验所消耗的 Token),并在各自实际测得的成本下,将每种方法与重复采样进行对比。所有 36 组对比均按问题进行了配对,并采用了 Self-bootstrap 采样区间与多重性修正(multiplicity correction)。
在相同成本下,没有任何方法在任何情况下能可靠地优于重复采样。有 10 组对比的结果可靠地更差,它们全部属于模型检查自身输出的方法,且所有 18 组自我检查(self-inspection)对比均为负向结果。随着模型规模的扩大,两类自我检查方法表现出了不同的走势。选择策略不再具有伤害性:取 Best-of-N 的 8 个样本并仅统计最常见的答案,在 1.5B 模型上比让模型自行挑选分别高出 8.0 和 11.3 个百分点,但在 7B 模型上仅高出 2.0 和 1.3 个百分点,与零相比已无法区分。重写策略则未能恢复:在 7B 模型上,Self-Refine 与强制 Reflexion 仍比基线低 3.6 到 10.1 个百分点。
原版论文中所发表的 Reflexion 在最小的模型上从未触发过自身的重试机制。它每次都判定自己是正确的,从而默默地退化为了单条思维链。我们公开了代码、提示词、所有生成内容以及我们的验证脚本。
原文链接:https://arxiv.org/abs/2607.28576
前往小宇宙评论区与主播互动
【第733期】Zero-Mem:零令牌智能体存储系统
今天的这篇的主题是: Zero-Mem: Zero-Token Memory Operations for LLM Agents
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
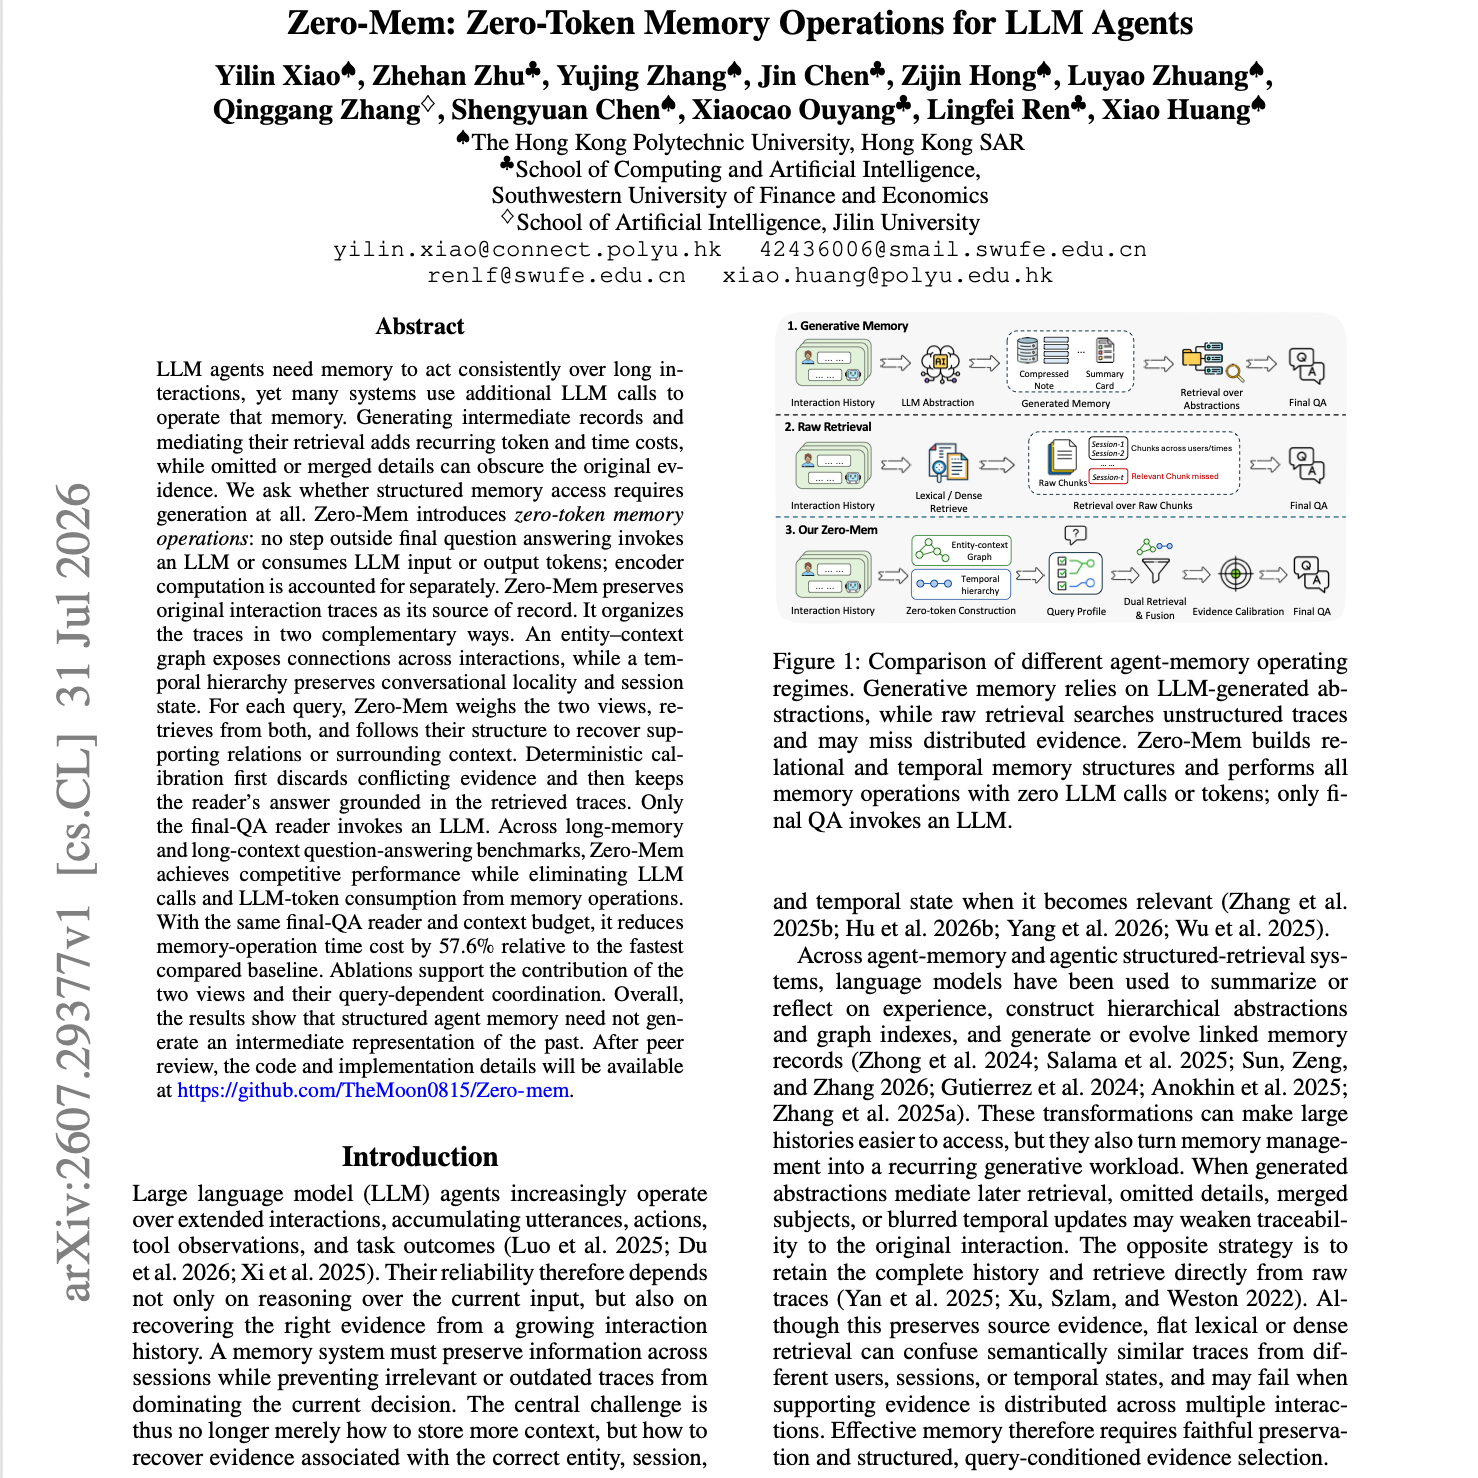
LLM 智能体(LLM agents)需要记忆才能在漫长的交互过程中保持行为一致,然而许多系统却依赖额外的 LLM 调用来运行该记忆机制。生成中间记录并中介其检索会增加持续发生的 Token 和时间成本,而遗漏或合并的细节可能会掩盖原始证据。我们探讨结构化记忆访问是否根本不需要进行生成。《Zero-Mem》引入了零 Token 记忆操作(zero-token memory operations):除了最终的问答环节外,没有任何步骤会调用 LLM,也不会消耗 LLM 的输入或输出 Token;编码器(encoder)的计算则单独统计。《Zero-Mem》将原始交互轨迹保留为其记录来源。它以两种互补的方式组织这些轨迹:实体-上下文图暴露了跨交互的关联,而时间层级结构则保留了对话的局部性(locality)与会话状态。对于每个查询,《Zero-Mem》权衡这两种视角,同时从中检索,并顺应其结构来恢复支撑性关系或周边上下文。确定性校准(deterministic calibration)首先剔除冲突的证据,进而确保阅读器(reader)的回答严格锚定于检索到的轨迹。只有负责最终问答的阅读器才会调用 LLM。在长记忆(long-memory)与长上下文问答基准测试中,《Zero-Mem》在消除记忆操作中的 LLM 调用及 LLM Token 消耗的同时,取得了具备竞争力的性能。在相同的最终问答阅读器和上下文预算下,相较于最快的对比基线,它将记忆操作的时间成本降低了 57.6%。消融实验证实了这两种视角及其依赖于查询的协调机制所做出的贡献。总体而言,结果表明结构化智能体记忆无需生成过去信息的中间表示。经过同行评审后,代码和实现细节将在该 https 链接处公布。
原文链接:https://arxiv.org/abs/2607.29377
前往小宇宙评论区与主播互动
【第732期】智能体故障定位的交互中心分类法
今天的这篇的主题是: Model or Harness? An Interaction-Centric Taxonomy for Localizing Agent Failures
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
现有评估通常将智能体(agent)的失败归结为系统层面的结果,掩盖了故障的始发位置以及哪种干预措施能够改进智能体系统。这就引发了一个“修复分配问题”(repair-assignment problem):相同的显性失败可能因其根源不同,分别需要模型后训练(post-training)、框架工程(harness engineering)、环境重构或基准测试修复。由于智能体行为是由模型、框架、用户、工具、记忆和环境之间的相互作用涌现而来的,因此结果层面的标签通常不足以指导改进。大多数失败分类法对解决这一问题的帮助微乎其微,因为它们依赖于特定的基准测试且缺乏统一的结构。我们提出了一种以交互为中心的分类法(interaction-centric taxonomy),该方法将失败准确定位至其发生的交互过程,并识别出相应的责任组件。该分类法整理了 41 种失败模式,将每种模式分别归属于两个组件之间的连接边,并指定了指示修复归属的故障方(fault side)。这使得该分类法具备了可操作性:模型侧的失败指明了后训练的目标;框架侧的失败指向了脚手架(scaffolding)与工具集成的修复;而环境或评分器(grader)的失败则揭示了需要重新设计的评估条件。该模式适用于各种智能体架构,从代码助手到长流程个人助手以及多智能体系统。我们通过来自公开基准测试、模型系统卡(system cards)、已发表报告和记录的智能体轨迹中的具体示例对该分类法进行了奠基,并使用独立的推理智能体作为裁判评估了其可复现性。在涵盖 4 个前沿模型的测试中,最强裁判对人类类别标签的一致性系数达到了 Cohen's κ=0.76,这表明这些类别捕捉到了公认的结构特征,而非特定标注者的偏好。
原文链接:https://arxiv.org/abs/2607.28802
前往小宇宙评论区与主播互动
【第731期】AgentThread:大模型代理协议的形式化安全分析与验证
今天的这篇的主题是: Formal Security Analysis of Agent Protocol Composition
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
AI 智能体协议定义了智能体如何使用工具、委托工作以及在不同软件系统间进行协调,但它们的安全需求仍不完善,且在不同部署中的执行情况也并不一致。我们提出了 AgentThread,这是一个源链式(source-linked)框架,用于对智能体协议进行从规范文本到运行中 SDK 的安全保证分析。AgentThread 贡献了一个分层的安全范畴,将源自协议的检查形式化为 TLA+ 约束不变式,并提供了一个双阶段检查器——该检查器能将协议规范编译为可进行模型检验的模型,并通过协议适配器针对真实 SDK 重放可执行的反例。对于每一项发现,AgentThread 都会记录检查背后的源文本,并将被违反的协议需求与缺失的建议、加固缺陷以及未分配的跨协议责任区分开来。
在涵盖 5 个新兴智能体协议的测试中,AgentThread 识别出了 35 个规范层面的发现,通过对生产级 SDK 和参考服务器进行的 80 个实现测试对其提供了支持,并发现了仅在协议组合下才会出现的 30 个额外失效案例。我们进一步表明,实际上仅有一个协议执行了与安全相关的控制,且没有协议为跨协议行为分配执行责任。因此,智能体协议的不安全性不仅是一个规范或实现问题,也是跨协议、SDK 和部署的责任鸿沟。
原文链接:https://arxiv.org/abs/2606.28690
前往小宇宙评论区与主播互动
【第730期】InterSAGE:智能体互联网的安全性与可验证互操作协议
今天的这篇的主题是: InterSAGE: The Secure and Verifiable Interoperability Protocol for An Internet of Agents
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
新兴的智能体互联网(Internet of Agents)使基于大语言模型的智能体能够跨越组织边界发现同行、调用工具并委托任务。现有协议越来越多地定义了智能体之间如何交换消息,但并未定义智能体在委托发生后如何证明其身份、授权、宣称的能力或责任归属。我们提出了 InterSAGE,这是一个信任原生的协议套件,它与通信协议并行提供(而非取代)了这一缺失的安全底层。InterSAGE 由四个层级组成:持久身份、发现、信任协商与责任归属。其四大核心原语为:(1)绑定开发者、代码包、运算符和部署上下文的智能体身份卡;(2)使用绑定 DID 的可验证凭证清单进行具备能力感知的发现;(3)将单调能力衰减与双层访问控制相结合的信任协商;以及(4)在无需共识账本的情况下,将使用情况、委托和执行轨迹绑定至智能体身份的内核介导加密审计轨迹。InterSAGE 旨在对 MCP、A2A、ANP 和 AG-UI 进行补充,使通信协议能够独立演进,同时保持信任语义的明确性、可移植性和可验证性。我们将 InterSAGE 与涵盖智能体协议、去中心化身份、OAuth/OIDC 扩展、零信任治理、委托及审计架构的 50 多项相关工作进行了比较。我们表明,先前的架构中没有一种能够将持久身份、能力感知发现、信任协商和责任归属作为统一的四层信任底层来共同执行,以实现安全的智能体互操作性。
原文链接:https://arxiv.org/abs/2608.13030
前往小宇宙评论区与主播互动
【第729期】Agent文件系统代理存储:组织、演化与可持续性研究
今天的这篇的主题是: Filesystem-Based Memory for LLM Agents: Organization, Evolution, and Sustainability
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
部署的 LLM 智能体(LLM agents)越来越倾向于将长期记忆以文件系统的形式保存:一个由 Markdown 文件组成的目录树,智能体自身通过通用的文件工具进行读取、写入和重组。然而,学术研究在很大程度上忽略了这一介质:先前的系统通常设计定制化的记忆表示形式并针对其研究检索,使得默认方案的两个关键假设未经检验:即随着记忆的累积、冲突和过时,智能体能够保持一个不断增长的存储库处于有序状态;以及这种组织方式确实能带来收益。本文对基于文件系统的智能体记忆进行了首次系统性探索。我们将该场景正式化为一个围绕单一记忆文件系统展开的三重角色模型:管理智能体负责整合并组织传入的内容,检索智能体负责使用引用来源回答查询,执行智能体则提供任务轨迹并将其提炼为技能,从而在单个存储库中统一了声明性记忆与技能。在长对话基准和具身任务中,随着记忆的增长,我们改变了记忆形态(智能体组织的层级结构、逐字转储、块检索)、流规模、工具套件(沙盒 Shell、记忆工具风格的函数、多样化的搜索工具)以及管理与检索智能体的能力,同时跟踪回答质量、成本和存储库的健康状况。有序组织能可靠带来的优势是搜索经济性:在资料规模庞大时,有序的存储库能使检索成本降低约一半。然而,当今的智能体未能实现默认方案的承诺:在我们的增长研究中,除了最强的管理智能体之外,所有智能体的组织结构都会发生侵蚀;并且我们测试的所有智能体都未能将组织本身转化为更好的回答质量。此外,模型并非决定存储库形态的唯一杠杆:仅更换工具集就能对存储库形态产生与更换模型同样强烈的重塑作用。本研究将文件系统这一默认方案从一项盲目的假设转变为智能体记忆的设计空间。
原文链接:https://arxiv.org/abs/2607.26637
前往小宇宙评论区与主播互动
【第728期】ACM:面向长时任务的自主语境管理框架
今天的这篇的主题是: ACM: Agentic Context Management for Long Horizon Tasks
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
Agent 化任务在本质上具有长视角(long-horizon)与多轮交互的特点,会在与环境的互动中不断积累上下文。现有的上下文压缩方法不可避免地会带来信息损失,并且通常由僵化的启发式规则触发,导致它们无法与 Agent 动态演进的推理焦点保持对齐。
我们提出了 Agentic Context Management(ACM,Agent 化上下文管理),这是一个为 Agent 配备专用上下文编辑工具以实现无损上下文管理的框架。受人类短时记忆与长时记忆相互作用的启发,Agent 能够自主决定何时压缩其上下文,将废弃的内容卸载(offload)至外部记忆系统,并在后续需要时根据检索需求对其发起查询。
基于该框架,我们进一步开发了一个后训练(post-training)流水线,用于构建高质量的上下文管理演示数据,并提升模型在 Agent 化搜索与编程任务上的性能。深入分析表明,有效的上下文管理能够减轻峰值 token 压力,支持更深入长久的探索,并在独立试验中产生更加稳定一致的解决方案。代码、数据和模型 Checkpoints 已在该 URL(this https URL)处提供。
原文链接:https://arxiv.org/abs/2607.23809
前往小宇宙评论区与主播互动
【第727期】JAXBench:自主TPU内核优化评测基准
今天的这篇的主题是: JAXBench: Benchmarking Autonomous TPU Kernel Optimization
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
严格的基准测试通过确立可供攀登的共同目标,推动了自主 GPU 内核性能优化领域的进步,但 TPU 领域尚无同等效力的基准。我们推出了 JAXBench,这是一个在 Google Cloud TPU 上用于 AI 生成内核优化的 TPU 原生基准测试套件。
JAXBench 包含 50 个既具备实际相关性又留有优化空间(headroom)的 JAX 工作负载。我们从公共 MaxText 库中的架构(如 Llama-3.1、DeepSeek-V3、Mixtral、Mamba-2 和 AlphaFold2)中提取了 17 个生产级 ML 算子,并从 KernelBench 中翻译了 33 个经正确性验证的算子,同时设置了能够实现高 TPU v6e MXU 利用率的新问题规模。在 17 个生产级算子中,有 8 个附带了来自公共 Tokamax 库且经过分块大小调优(block-size tuned)的手工优化 Pallas 内核,以确立专家级上限基线。
我们评估了四种基于反馈的方法在为 JAXBench 生成候选 Pallas 内核上的表现。在配合 Gemini 3 Flash 的全套基准测试中,我们发现对于像 Pallas 这样缺乏丰富文档的 DSL 而言,特定于目标的上下文比模型规模更为关键。提供精心挑选的 TPU 文档上下文,可将单样本正确率(per-sample correctness)从 5.8% 提升至 37.3%,并在 50 个基准测试中解决了 48 个,实现了 1.28 倍的几何平均加速比。
一旦实现正确性,搜索结构就会带来显著收益:Autocomp 的束搜索(beam-search)流水线相比 XLA 达到了 1.36 倍的几何平均加速比。在 8 个手工调优的内核上,Autocomp 相比 XLA 取得了 1.60 倍的几何平均加速比,恢复了 Tokamax 2.08 倍上限的大部分性能,但在专用的分页(paged)和不规则(ragged)注意力算子方面仍稍显逊色。
高质量的 TPU 内核优化仍是一项极具挑战性的任务,我们现发布 JAXBench 基准测试、评估框架(harness)以及基线结果,以支持开源社区的贡献。
原文链接:https://arxiv.org/abs/2607.20466
前往小宇宙评论区与主播互动
【第726期】Molt:面向代理强化学习的可扩展原生PyTorch训练框架
今天的这篇的主题是: Molt: A Scalable PyTorch-Native Training Framework for Agentic Reinforcement Learning
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
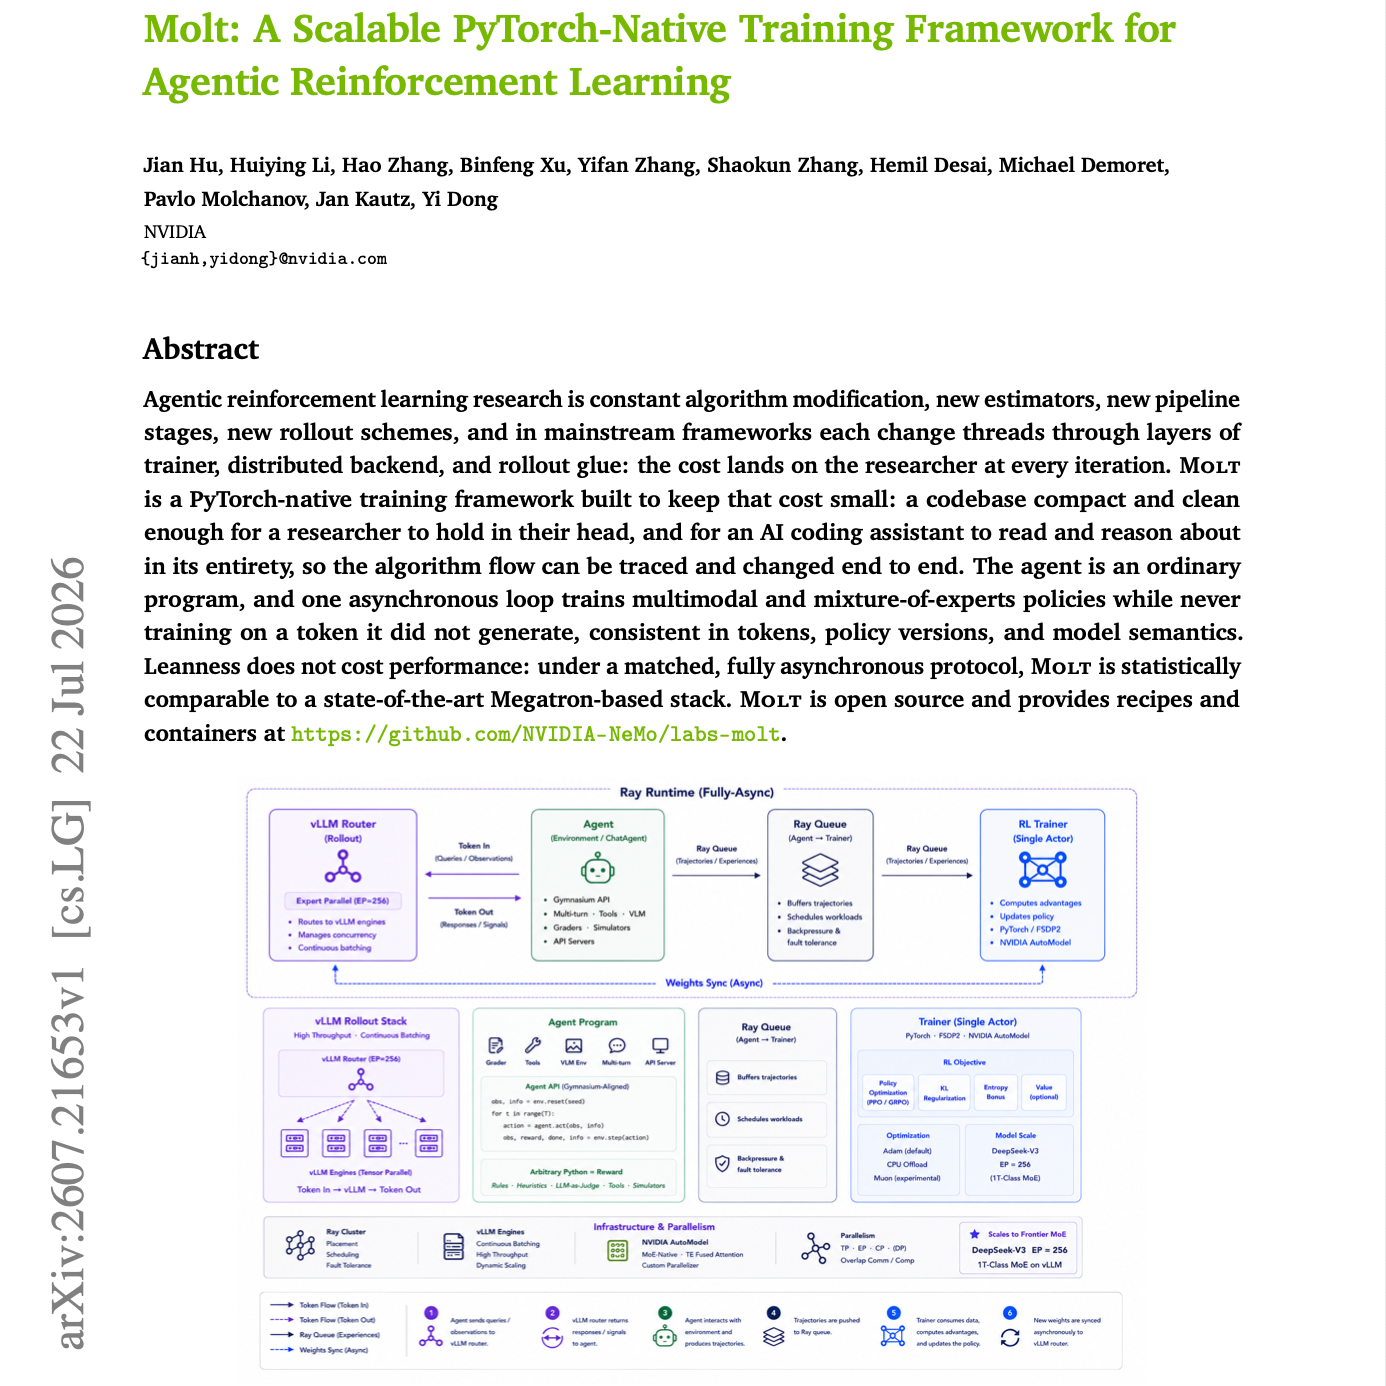
Agent 化强化学习(Agentic reinforcement learning)研究伴随着频繁的算法修改、全新的估计器(estimators)、新的流水线阶段以及新的采样方案(rollout schemes)。而在主流框架中,每项修改都会穿透训练器(trainer)、分布式后端以及采样胶水层(rollout glue):这种研发成本在每次迭代中都会落到研究人员头上。
Molt 是一个基于 PyTorch 原生构建的训练框架,旨在降低上述成本:其代码库精简且清晰,足以让研究人员将其完全记在脑海中,也足以让 AI 编程助手对其完整代码进行阅读与推理,从而使算法流程能够实现端到端的追踪与修改。在 Molt 中,Agent 就是一个普通的程序,并且通过单个异步循环即可完成多模态与混合专家(Mixture-of-Experts)策略的训练,同时绝不在未生成的 token 上进行训练,在 token、策略版本和模型语义上保持了一致性。
精简并不以牺牲性能为代价:在对齐的完全异步协议下,Molt 在统计学意义上与基于 Megatron 的最先进技术栈相当。Molt 已开源,并在该 URL(this https URL)处提供了 Recipes 与容器配置。
原文链接:https://arxiv.org/abs/2607.21653
前往小宇宙评论区与主播互动
【第725期】隐性推理:大模型中不可见的计算过程
今天的这篇的主题是: Not All LLM Reasoning is Visible in the Chain-of-Thought
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
AI 安全面临的一个关键问题在于,语言模型是否在其输出 token 中表达了其全部的推理过程。我们展示了一种具体的失效模式(failure mode):前沿模型通过利用在语义上无关的填充 token(filler tokens)来提升在合成推理任务上的性能,从而表现出了“隐形推理”(invisible reasoning)。
我们在三项任务上评估了 13 个前沿语言模型,发现许多模型能从填充 token 中显著获益,准确率提升最高可达 13 个百分点。这种收益取决于使用了哪些 token,且在不同模型间存在差异。我们进一步表明,填充 token 能够使 Claude Opus 4.5 在不牺牲其主要任务准确率的前提下,满足一项隐藏的同余算术(modular arithmetic)约束,这证明了隐形推理可以服务于对思维链(CoT)监控而言完全不可见的目标。
强化学习使 Qwen3-235B 对填充 token 的内容产生了强烈的偏好,但无论是强化学习还是监督微调,都未能产生在测试阶段持续存在的填充 token 收益。我们的结果表明,前沿模型已经在进行不带任何可解释输出 token 痕迹的重大计算(consequential computation)。
原文链接:https://arxiv.org/abs/2607.22925
前往小宇宙评论区与主播互动
【第724期】ReOPD:多轮交互的重播前缀在线策略蒸馏
今天的这篇的主题是: Multi-Turn On-Policy Distillation with Prefix Replay
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
我们研究了针对 Agent 任务的在线策略蒸馏(On-policy Distillation, OPD)。在这些任务中,大型语言模型(LLM)Agent 跨越多个轮次与环境进行交互,学生模型在这些多轮交互历史中对教师模型进行模仿。完全在线的 OPD 成本极高,因为每一次更新都需要学生模型在环境中进行全新的采样(rollouts),并在所访问的历史节点处向教师模型发起查询。
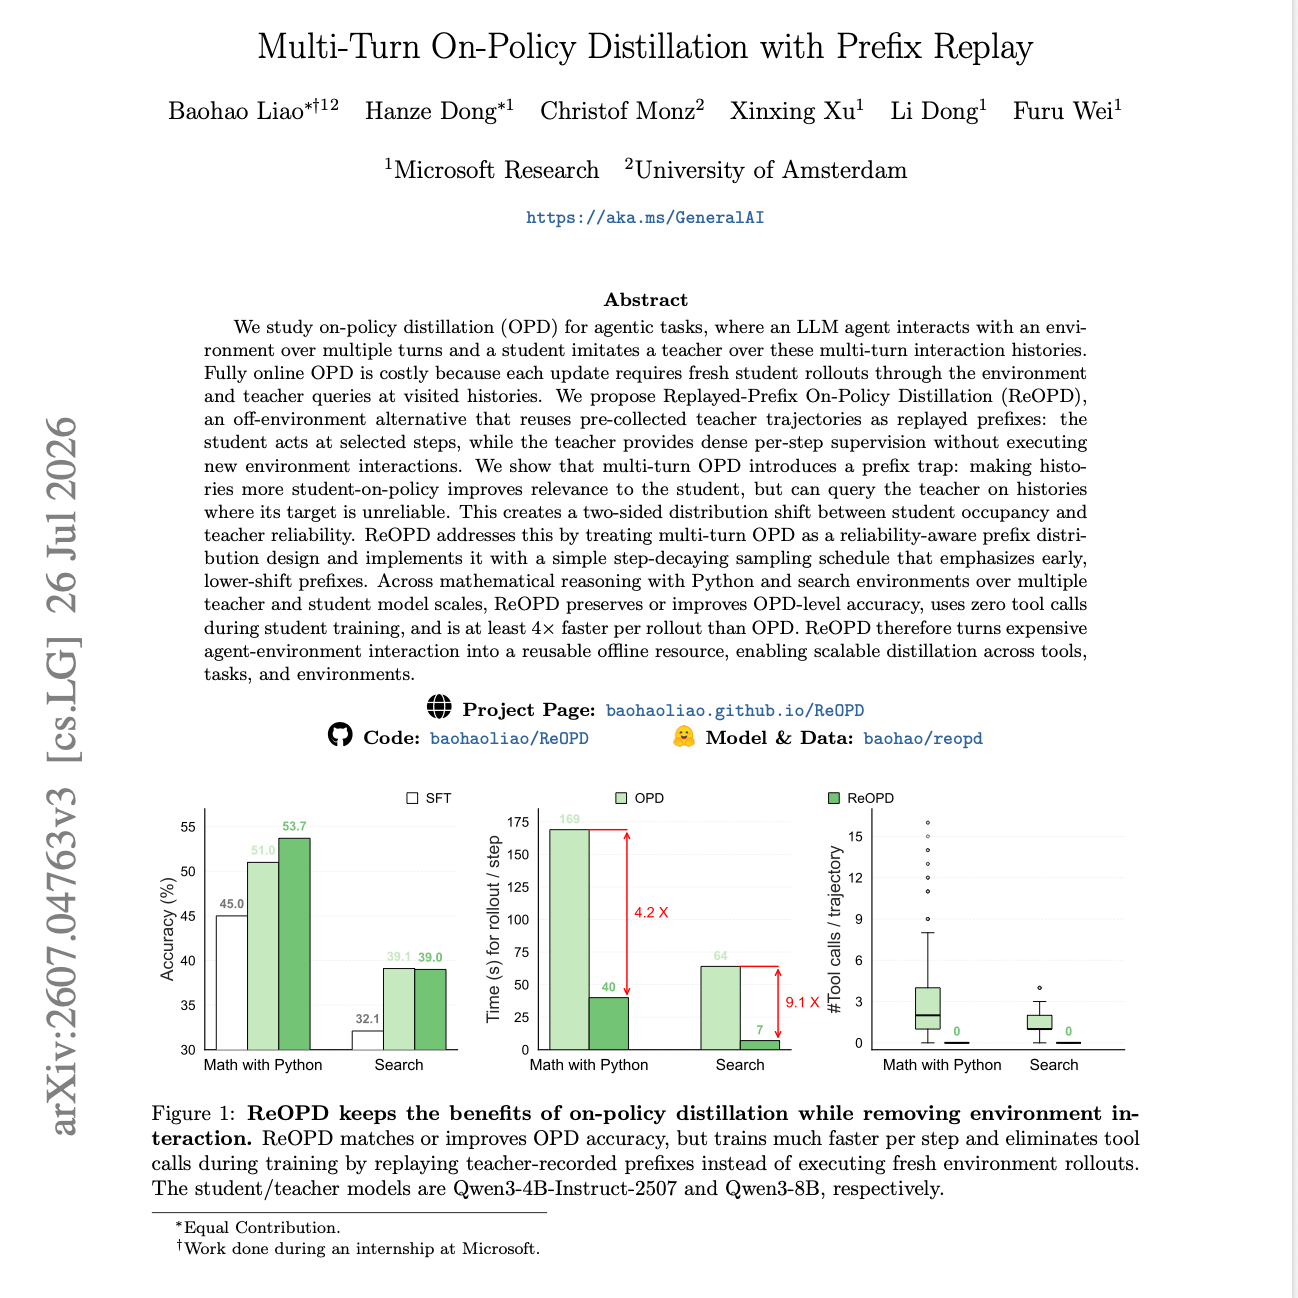
我们提出了重放前缀在线策略蒸馏(Replayed-Prefix On-Policy Distillation, ReOPD),这是一种离线环境(off-environment)的替代方案,它将预先收集的教师轨迹复用为重放前缀:学生模型在选定的步骤执行动作,而教师模型提供密集的逐步监督,无需执行新的环境交互。
我们展示了多轮 OPD 会引发一个“前缀陷阱”(prefix trap):提高历史轨迹对学生在线策略的适配度(student-on-policy)能够提升其对学生模型的相关性,但却可能在教师模型目标不可靠的历史节点上对其发起查询。这就构成了学生模型占有率(student occupancy)与教师模型可靠性之间的双向分布偏移(two-sided distribution shift)。
ReOPD 通过将多轮 OPD 视为一种感知可靠性的前缀分布设计来解决这一问题,并通过简单的时间步衰减采样调度(step-decaying sampling schedule)加以实现,该调度侧重于早期、分布偏移较低的前缀。在结合 Python 的数学推理以及跨多种教师和学生模型规模的搜索环境实验中,ReOPD 保持或提升了 OPD 级别的准确率,在学生训练期间实现零工具调用,且每次采样的速度比 OPD 提升了至少 4 倍。因此,ReOPD 将昂贵的 Agent-环境交互转化为了可复用的离线资源,实现了跨工具、跨任务和跨环境的可扩展蒸馏。
原文链接:https://arxiv.org/abs/2607.04763
前往小宇宙评论区与主播互动
【第723期】NOOA:基于面向对象编程的原生Python智能体框架
今天的这篇的主题是: NVIDIA-labs OO Agents Native Python Object-Oriented Agents
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
传统 Agent 的开发分散于提示词模板(prompt templates)、工具 Schema、回调代码(callback code)以及工作流图(workflow graphs)之中。我们推出了 NVIDIA 面向对象 Agent(NOOA),这是一个用于构建可靠 AI Agent 的通用(model-agnostic)Python 框架。NOOA 采取了一种更为简洁的方法:一个 Agent 就是一个 Python 对象。它的方法即为模型可以采取的动作,属性字段即为其状态,文档字符串(docstrings)即为其提示词,而其类型注解则构成了契约约束。代码体仅由“...”组成的方法会在运行时由 LLM 驱动的 Agent 循环来完成,而包含常规代码体的方法则保持为标准、确定性的 Python 代码。这为开发者和 Agent 提供了相同的接口,使得 Agent 的行为可以像其他软件一样被测试、追踪、重构和改进。
本论文做出了三项主要贡献:
(1) 我们提出了“ Agent 即 Python 对象”(agent-as-a-Python-object)的编程模型及其背后的设计原则。在 Python 已有相应抽象的地方,我们直接沿用它们。Agent 的专属能力——如上下文、事件、状态渲染、长期记忆以及经过验证的 LLM 循环——均通过符合 Python 习惯的简洁 API 暴露出来,从而让开发者和 Agent 共享同一种熟悉的编程模型。
(2) 我们总结了六项面向模型的理念,就我们所知,NOOA 是首个在单一统一接口上将它们融为一体的框架:类型化输入/输出、对活对象的引用传递(pass-by-reference over live objects)、代码即动作(code as action)、可编程循环工程(programmable loop engineering)、显式对象状态,以及面向模型可调用的上下文与事件测试框架(harness)API。我们发现社区已经在向其中多项理念收敛(通常作为实验性或部分特性),在此提出这一对比旨在鼓励这些理念被进一步采用。
(3) 我们在定向能力测试以及诸如 SWE-bench Verified、Terminal-Bench 2.0 和 ARC-AGI-3 等 Agent 化与推理基准测试中证明,当前模型能够有效地使用这一接口。
原文链接:https://arxiv.org/abs/2607.20709
前往小宇宙评论区与主播互动
【第722期】RoboTTT:通过测试时训练扩展机器人策略上下文
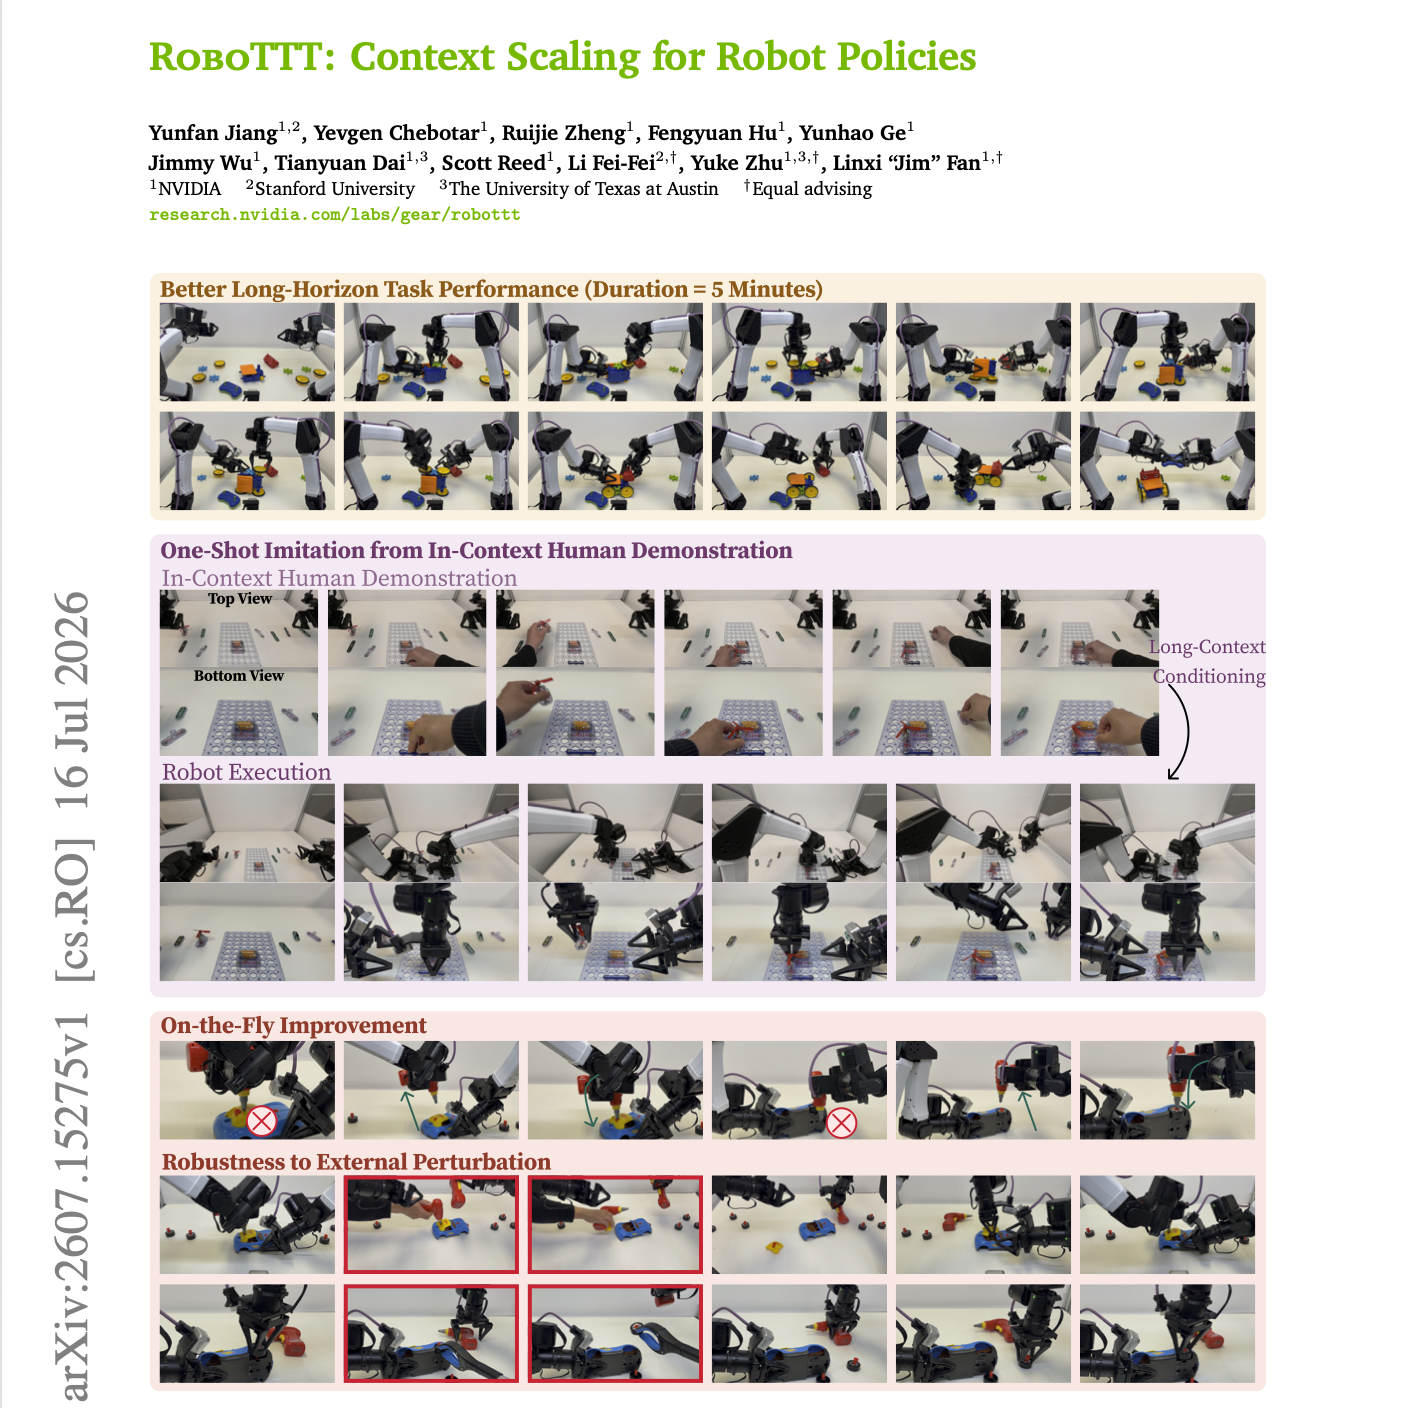
今天的这篇的主题是: RoboTTT: Context Scaling for Robot Policies
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
近期的机器人基础模型通常在单步或短历史的视觉运动(visuomotor)上下文下运行。我们推出了测试时训练机器人策略(RoboTTT),这是一种将视觉运动上下文扩展至 8K 个时间步(比现有最先进策略高出三个数量级)且不会增加推理延迟的机器人模型与训练方案。在这种上下文长度下,我们解锁了全新的机器人能力:从人类视频演示中实现单样本即时上下文模仿(one-shot in-context imitation)、实时策略改进、对扰动的鲁棒性,以及在多阶段、长视角(long-horizon)任务中更强的表现。此外,我们还首次观察到随着预训练上下文长度的扩展,闭环性能获得了稳步提升。
RoboTTT 的核心在于将测试时训练(Test-Time Training)集成到诸如视觉-语言-动作(Vision-Language-Action)策略等机器人基础模型中,构建出一个序列模型,其循环状态(recurrent state)由“快速权重”(fast weights)构成——即在训练和推理过程中均通过梯度下降更新的参数,将历史信息压缩至权重空间,并为长上下文条件化检索上下文信息。为了扩展训练上下文长度,该方案结合了序列动作强制(sequence action forcing)与截断按时间反向传播(truncated backpropagation through time)。
在具挑战性的真实机器人操控任务中,RoboTTT 相比单步上下文基线将整体性能提升了 87%,并完整完成了一项耗时 5 分钟、包含 10 个阶段的装配任务,而无任何基线模型能够做到这一点。使用 8K 时间步上下文训练的 RoboTTT 比使用 1K 时间步预训练的同一模型性能高出 62%,这表明上下文长度可以作为机器人基础模型的一个全新扩展轴(scaling axis)。
原文链接:https://arxiv.org/abs/2607.15275
前往小宇宙评论区与主播互动
【第721期】结构化输出引发的语言模型答案同质化研究
今天的这篇的主题是: Structured Output Collapses Answer Diversity Across 44 Language Models
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
当语言模型必须从庞大的等效有效选项空间中选择一个答案时,格式子句(例如“仅以 JSON 格式回复”)会改变其最终选择的答案。我们重新运行了“单词人口普查”(One-Word Census,arXiv:2607.12796):针对 44 个模型提出了 31 个具有宽泛答案空间的类别提示词,而本次则要求以 JSON 格式回复——无模式(schema)强制约束,无约束解码,仅包含这一请求。
收敛程度急剧加深:在无约束的“选择一个词”提示下,众数答案(modal answer)在总体中的占比从 41% 上升至 64%,而独立答案的数量则从 52 个降至 36 个;平均答案选择惊奇度(surprisal)从 1.80 比特降至 1.58 比特。这种“格式税”呈现出渐进性:在 44 个模型中有 6 个模型在个体层面上发生了显著偏移(BH-FDR q=0.10),且全部向众数靠拢,并以最具个性(最独特)的模型为首,而顺从型模型的基线则保持不动。
这是一种“尖锐化”而非“重新索引”——普通对话模式下的众数答案在 31 个类别中的 28 个里得以延续。默认选择呈现出语域索引特征(register-indexed):一次运行内的重采样(n=20)发现,JSON 使得模型 53% 的稳定对话默认选择发生了偏移,且绝大多数退回到了从众选择,并确立了对话模式中不存在的默认选项(例如 Claude Fable 5 在对话模式下回答颜色的选项为“蔚蓝色”的概率为 0%,但在 JSON 模式下为 100%)。
全套对照实验揭示了一种语域梯度(register gradient):压缩效应显著存在,且专门作用于经过训练、专门用于输出的答案交付格式(JSON 减少 0.22 比特,p=0.0002;XML 减少 0.19 比特,p=0.002);该效应在 YAML 和 CSV 中不存在,而在任意括号包裹格式中则发生反转(增加 0.13 比特,p=0.009)——这使得其作用机制更偏向于工具调用的后训练(tool-use post-training)。
在解码器端强制执行模式(response_format)相比单纯的文本请求并不会带来进一步的压缩(仅减少 0.03 比特):这种坍缩存在于模型对语域的反应中,而非来自于解码器本身。结构化输出是软件消费语言模型的主要方式,而这一表面所服务的是一个在测量上比对话表面更加同质化的模型——而后者恰恰是模型被评估、比较和选择时所基于的表面。
原文链接:https://arxiv.org/abs/2607.18476
前往小宇宙评论区与主播互动
【第720期】智能代理的长文本进阶披露机制评估
今天的这篇的主题是: Is Progressive Disclosure All You Need for Long-Context Agents?
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
长文档问答通常迫使人们在两种方案之间做出选择:要么将整份文档加载到上下文窗口中,要么外挂一个独立的检索器。Agent 化 AI(Agentic AI)则提供了一个更为宽泛的选项——直接向 Agent 提供文档路径,让其自行决定阅读的方式与内容。Agent Skills 作为一种将专业知识封装到文件夹中供 Agent 按需加载的标准,提供了一种现成的机制:渐进式披露(progressive disclosure),即仅暴露查询所需的信息,从简短的描述一直延伸到特定的段落。从业者们迅速在整本书级别的理解任务中采用了这一模式,但支持此类选择的证据一直停留在轶事层面。
我们针对该模式开展了首次对照研究,在 InfiniteBench 基准上,跨越三种 Agent 框架(harnesses)和三个模型家族,将原始文档导航以及 Agent Skills 包的几种设计方案与传统混合检索器进行了对比。在单本书的场景下,收益取决于所使用的框架:当 Agent 对原始文档的导航能力较差时收益巨大,但当强力 Agent 框架本身就能自行拆分与检索时,收益则接近于零。当扩展到跨多本书的任务时,原始文档导航方式彻底崩溃,而单层渐进式披露的性能衰减则更为缓慢并一举取得领先。第二层更深度的路由层从无助益,有时甚至会直接损害准确率,因此一层就已经足够。渐进式披露换取的是上下文容量,而非智能:当强力 Agent 能够自行定位正确段落时它是冗余的,但一旦语料库增长到无法通过阅读来导航的规模时,它就成为了决定性的关键因素。
原文链接:https://arxiv.org/abs/2607.17598
前往小宇宙评论区与主播互动
【第719期】GAMUT:大语言模型长文本生成事实完备性评价基准
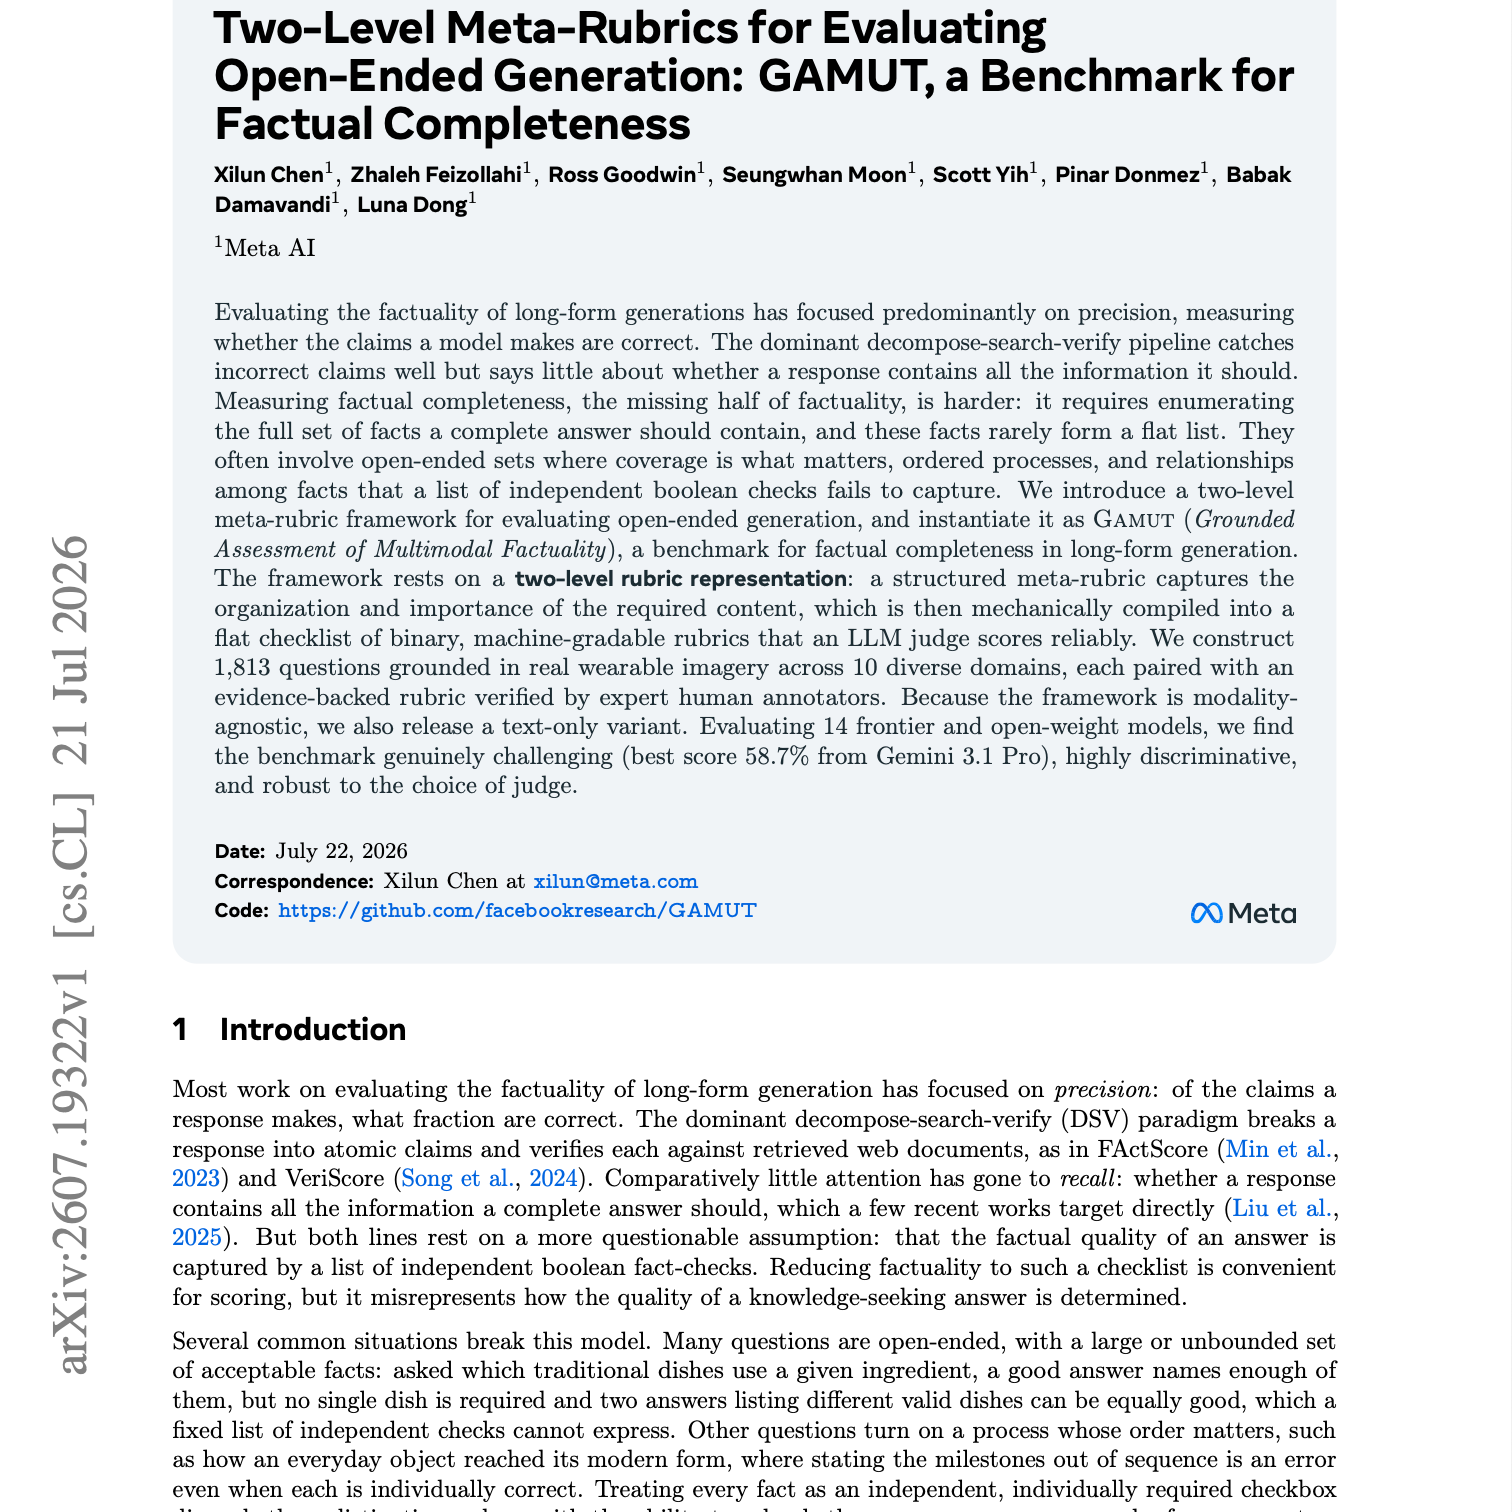
今天的这篇的主题是: Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
基于标准(Rubric-based)的开放式生成评估面临着表达力与可靠性之间的根本矛盾。撰写一份忠实准确的评估标准,需要表达出优秀回答空间所具备的结构特征:包含可接受选项的开放式集合、有序的流程以及事实的相对重要性。而使用该标准进行打分,则要求评估器(judge)保持一致性,评估器在处理扁平化的二元检查时,其可靠性远高于处理丰富的结构化内容。
我们通过一个两层元标准(meta-rubric)框架解决了这一矛盾。在撰写阶段,结构化元标准用于捕捉评分标准;随后,固定且机械化的规则会将其编译为由“二元、可由机器打分”的检查项目构成的扁平清单,LLM 评估器即可在评估阶段对其进行可靠的评分。
我们将该框架实例化为 Gamut(长文本事实性接地评估,Grounded Assessment of Multimodal Factuality),这是一个用于评估长文本生成中事实完整性的基准测试。Gamut 包含 1,813 个基于真实穿戴设备图像的问题,涵盖 10 个不同的领域,每个问题均配有由专家人类标注者验证且有证据支持的评估标准。在对 14 个前沿模型及开源模型进行评估后,我们发现 Gamut 极具挑战性(Gemini 3.1 Pro 取得了最高分 58.7%)、具备高度的区分度,且对评估器的选择具有很强的鲁棒性。
原文链接:https://arxiv.org/abs/2607.19322
前往小宇宙评论区与主播互动
【第718期】大语言模型中的全球工作空间:可言语化表征研究
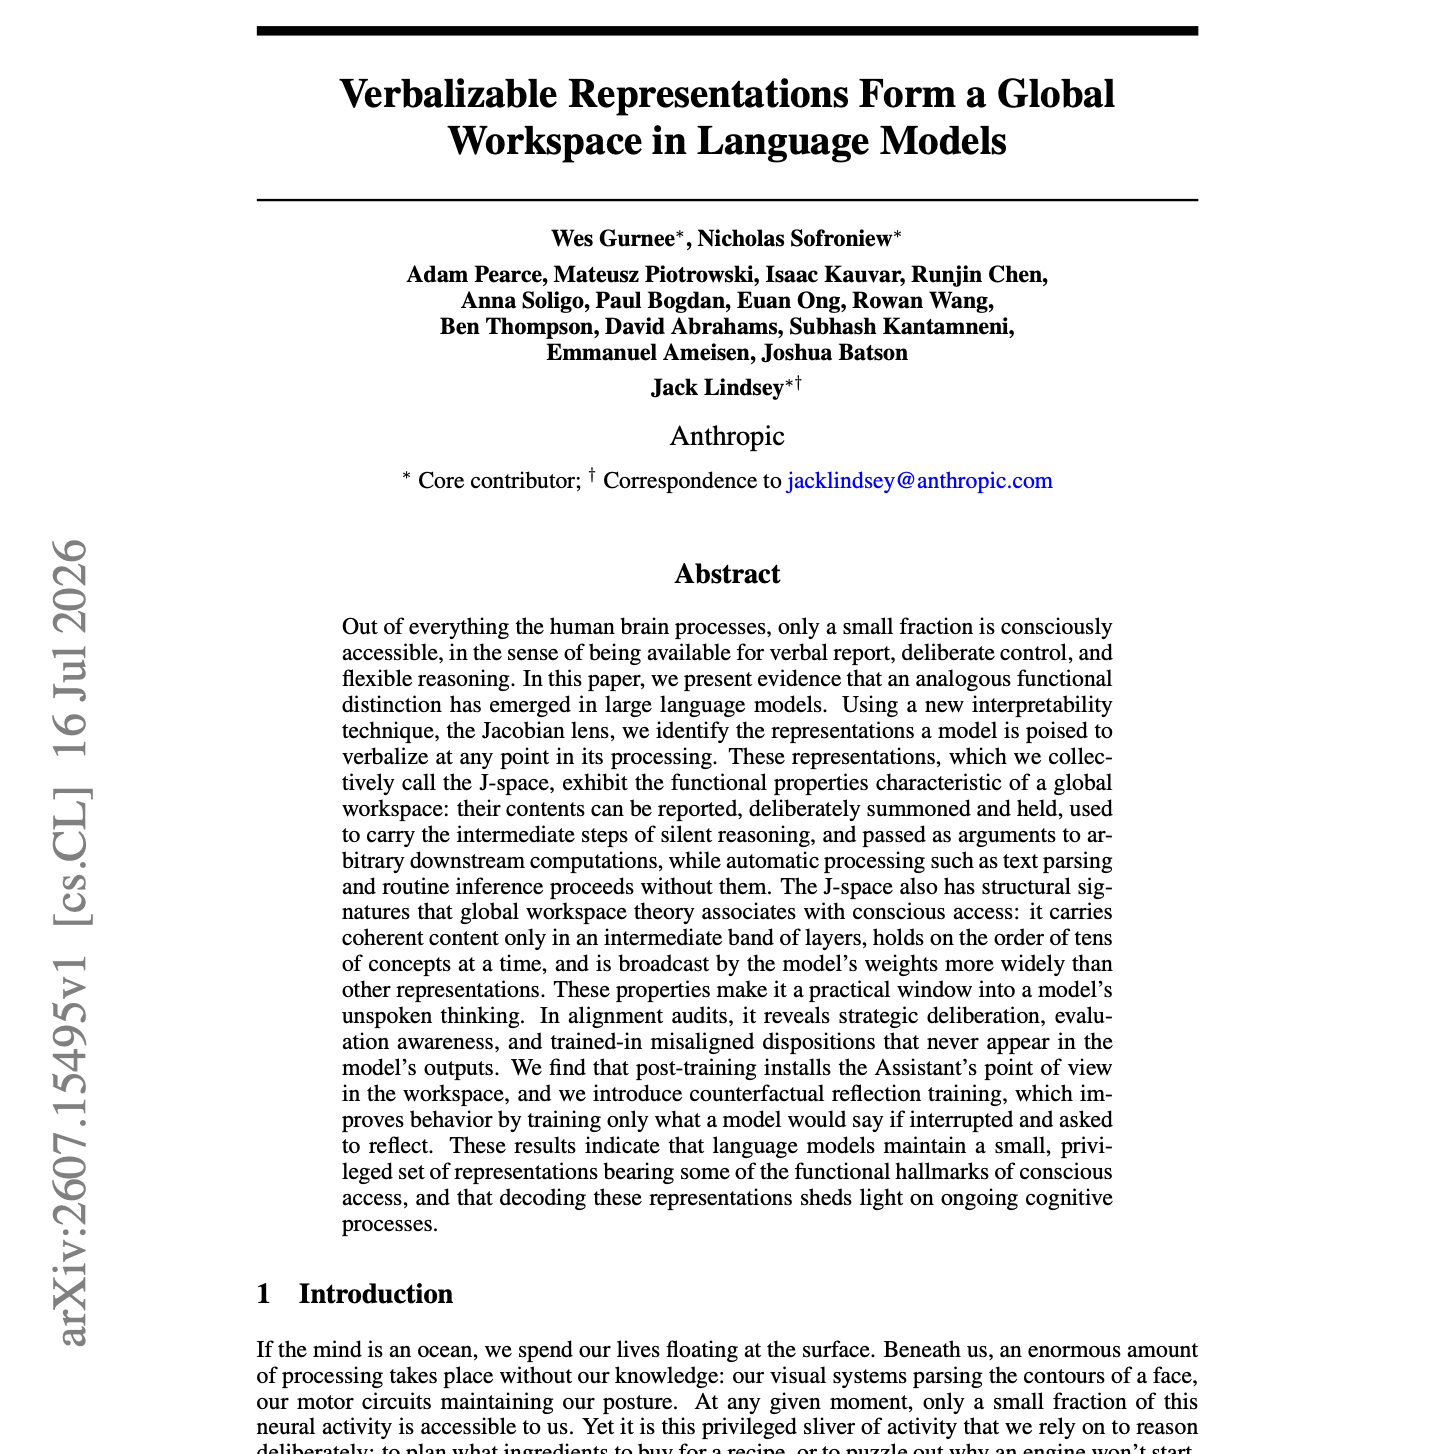
今天的这篇的主题是:Verbalizable Representations Form a Global Workspace in Language Models
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
在人类大脑处理的所有信息中,只有一小部分是能被意识到的,即能够用于口头报告、深思熟虑的控制以及灵活推理的信息。在本文中,我们提出证据表明,大型语言模型中也出现了类似的内部功能区分。利用一种全新的可解释性技术——雅可比透镜(Jacobian lens),我们识别出了模型在处理过程中的任意节点准备表达出的表征。这些表征被我们统称为 J 空间(J-space),它们展现出了全局工作空间(global workspace)所特有的功能属性:其内容可以被报告、被故意召唤和保持、用于承担隐蔽推理的中间步骤,并作为参数传递给任意下游计算;而文本解析和例行推理等自动处理过程则在无需它们参与的情况下 proceed(进行)。J 空间还具备全局工作空间理论与意识接入(conscious access)相联系的结构特征:它仅在中间层级带中承载连贯的内容,一次可容纳数十个概念数量级的知识,并且相比其他表征,它被模型的权重更为广泛地广播。这些特性使其成为了观察模型未说出的思考过程的实用窗口。在对齐审计中,它揭示了模型从未在其最终输出中呈现出的策略性深思、评估意识,以及训练所引入的不对齐倾向。我们发现,后训练(post-training)将“助手”(Assistant)的视角植入了该工作空间中,据此我们引入了逆事实反思训练(counterfactual reflection training),该方法仅通过训练模型在被中断并要求反思时会说些什么,就提升了其行为表现。这些结果表明,语言模型维持着一小部分具有意识接入某些功能特征的特权表征,而解码这些表征能够为揭示其持续进行的认知过程提供新的视角。
原文链接:https://arxiv.org/abs/2607.15495
前往小宇宙评论区与主播互动
【第717期】PRO-LONG:程序化记忆助力长程推理
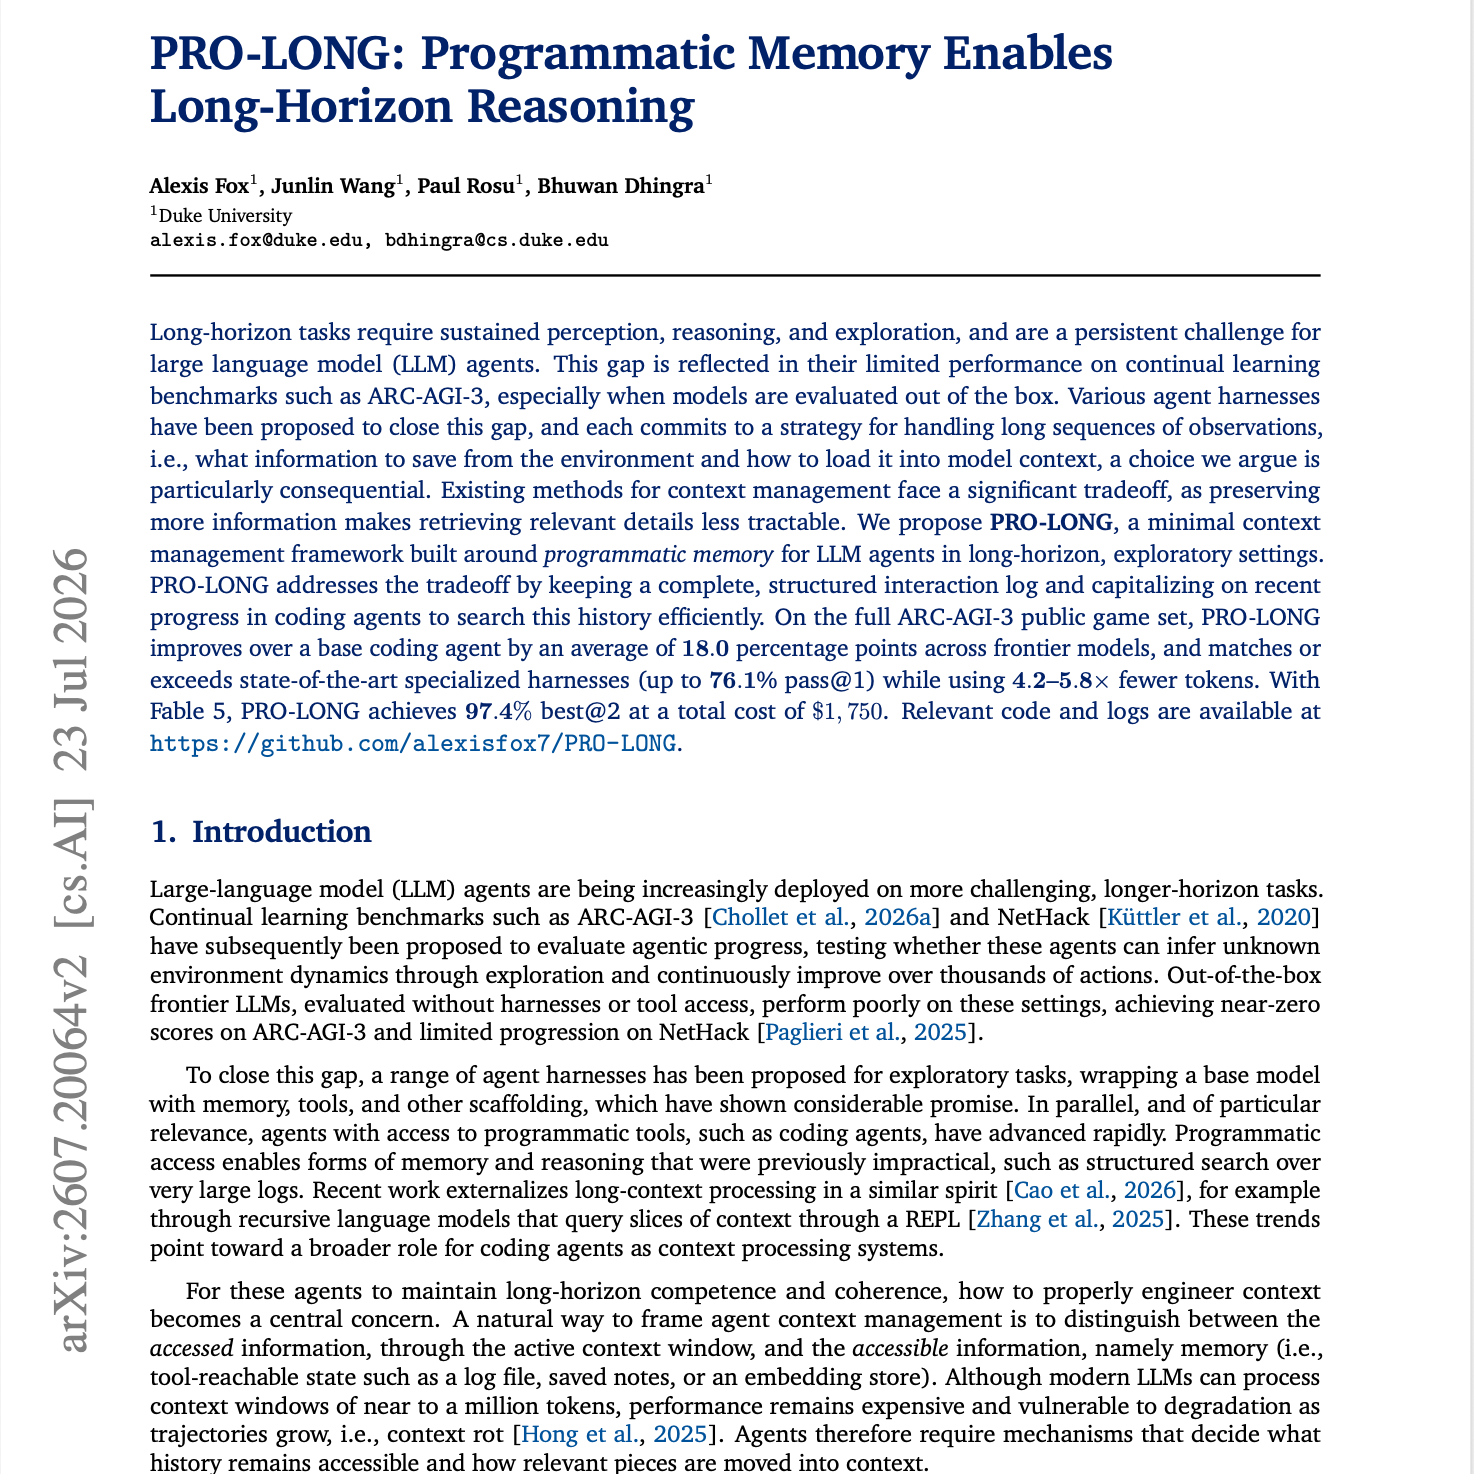
今天的这篇的主题是:
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
长视角(Long-horizon)任务需要持续的感知、推理与探索,这对于大型语言模型(LLM)Agent 而言是一项持久的挑战。这一差距体现在它们于 ARC-AGI-3 等持续学习基准测试中有限的表现上,尤其是当对模型进行开箱即用的评估时。为了弥合这一差距,业界提出了各种 Agent 框架(harnesses),且每种框架都致力于采用一种特定的长序列观察处理策略,即:从环境中保存什么信息,以及如何将其加载到模型上下文中——我们认为这一选择尤为关键。现有的上下文管理方法面临着显著的权衡取舍,因为保存越多的信息,检索相关细节的难度就越大。我们提出了 PRO-LONG,这是一个围绕程序化记忆构建的极简上下文管理框架,专为处于长视角、探索性设定下的 LLM Agent 设计。PRO-LONG 通过维护完整且结构化的交互日志,并借助编程 Agent 近期的进展来高效检索该历史记录,从而解决了这一权衡难题。在完整的 ARC-AGI-3 公开游戏集上,PRO-LONG 在前沿模型上的表现相比基础编程 Agent 平均提升了 18.0 个百分点,且在 token 消耗减少 4.2 至 5.8 倍的同时,达到或超越了最先进的专用框架(pass@1 最高达 76.1%)。配合 Fable 5,PRO-LONG 以 1,750 美元的总成本实现了 97.4% 的 best@2 成绩。
原文链接:https://arxiv.org/abs/2607.20064
前往小宇宙评论区与主播互动
【第716期】从记忆到技能:长程大语言模型智能体的循证协同演化治理
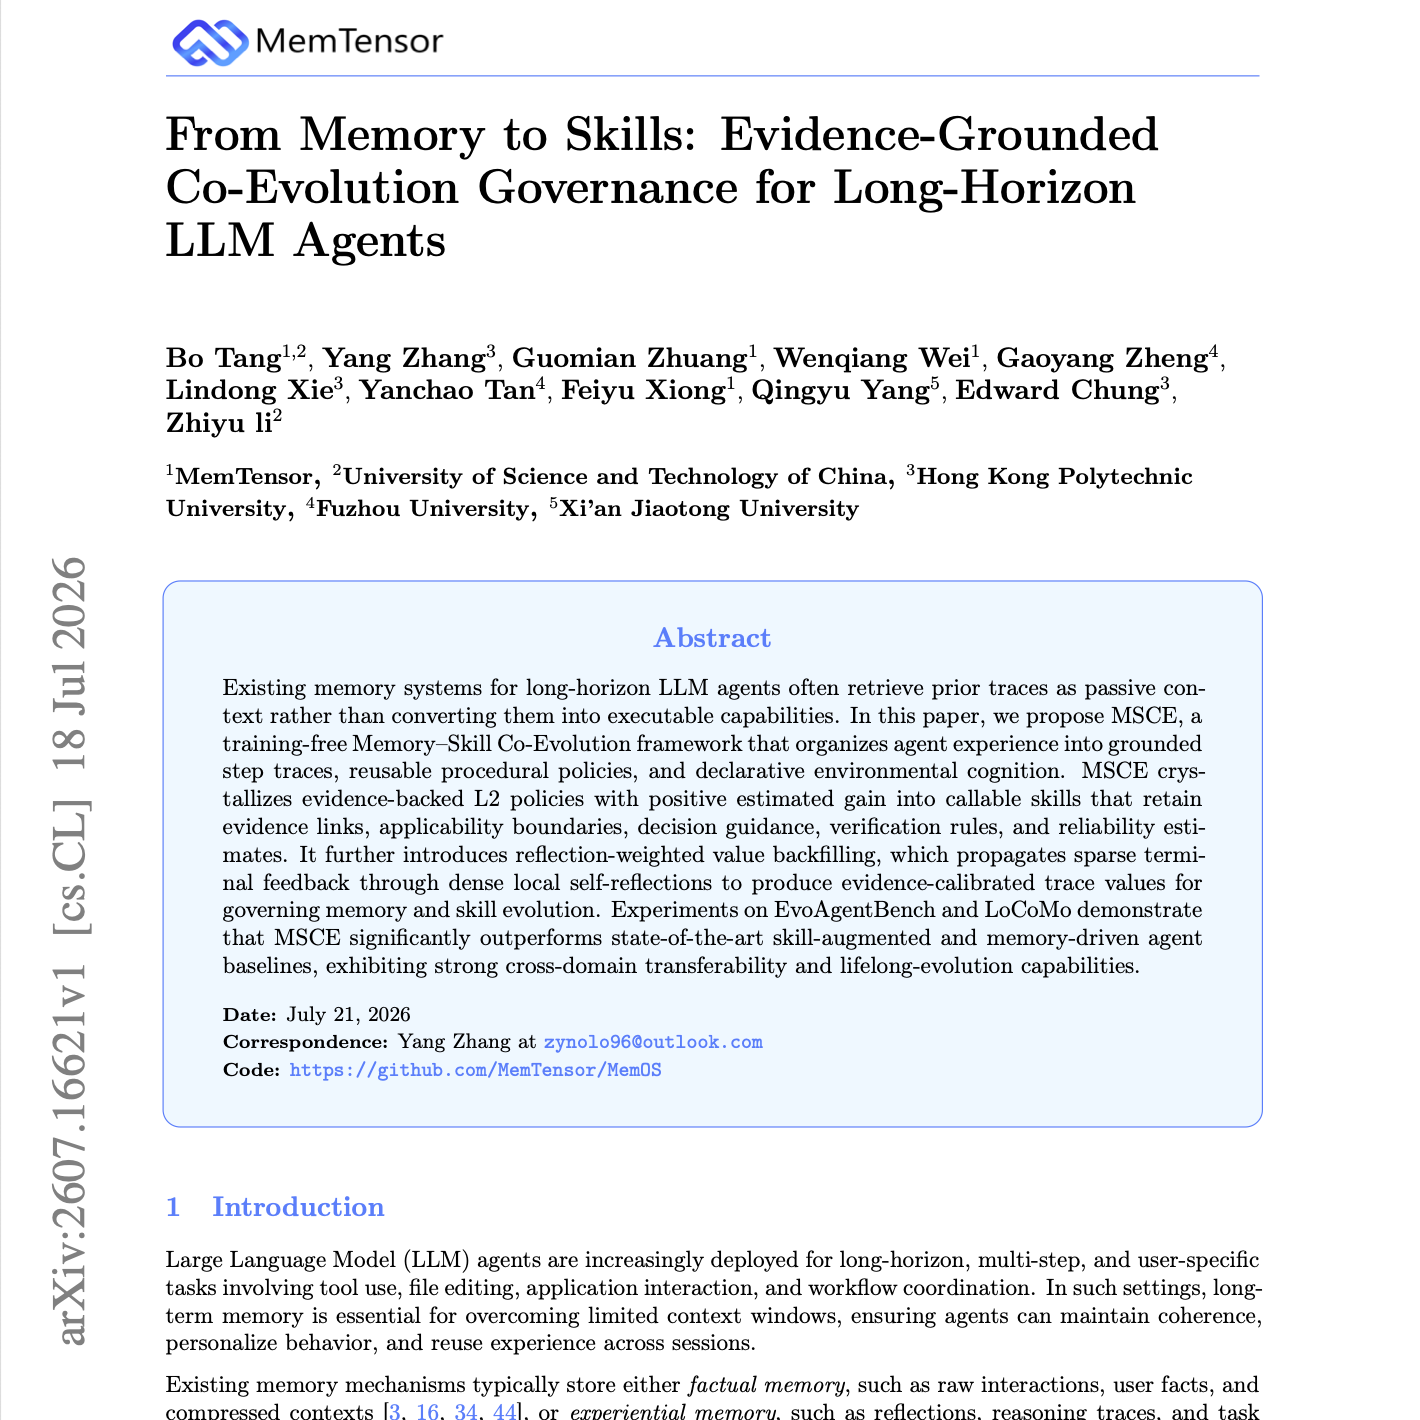
今天的这篇的主题是:From Memory to Skills: Evidence-Grounded Co-Evolution Governance for Long-Horizon LLM Agents
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:seventy3_podcast(加群/投稿论文)
Summary
用于长上下文 LLM Agent 的现有记忆系统通常将先前的轨迹作为被动上下文进行检索,而不是将其转化为可执行的能力。在本文中,我们提出了 MSCE,这是一个无需训练的“记忆-技能共进化”(Memory--Skill Co-Evolution)框架,它将 Agent 的经验组织为有据可查的步骤轨迹、可复用的程序性策略,以及宣告性的环境认知。MSCE 将具有估计正增益的、有证据支持的 L2 策略凝练为可调用的技能,这些技能保留了证据链接、适用性边界、决策指导、验证规则以及可靠性估计。此外,它还引入了基于反思权重的价值反向填补(reflection-weighted value backfilling),该机制通过密集的局部自我反思来传播稀疏的终端反馈,从而生成经过证据校准的轨迹价值,用于管理记忆与技能的进化。在 EvoAgentBench 和 LoCoMo 上的实验表明,MSCE 显著优于最先进的技能增强型和记忆驱动型 Agent 基线,展现出了强大的跨领域迁移能力和终身进化能力。
原文链接:https://arxiv.org/abs/2607.16621
前往小宇宙评论区与主播互动
【第715期】Harness Handbook:AI智能体框架行为化表征指南
今天的这篇的主题是:Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:seventy3_podcast(加群/投稿论文)
Summary
现代 AI Agent 的能力不仅取决于其基础模型,还取决于其 Harness(调度/治理框架)——后者负责构建 Prompt、管理状态、调用工具并协调执行过程。随着模型、API、环境和需求的不断演进,Harness 必须随之持续修改。在实施此类修改之前,开发者或编码 Agent 必须定位到实现目标行为的所有代码位置。这一过程十分困难,因为生产级 Harness 通常体量庞大、高度耦合且行为逻辑分散,而修改需求往往描述的是系统“应该做什么”,代码库却是按文件和模块组织的。代码搜索、代码库索引以及长上下文处理虽然减轻了查阅负担,但这种“行为到代码”的映射依然需要人工来恢复。因此,行为定位(Behavior localization) 成了 Harness 演进过程中的核心瓶颈。
为此,我们引入了 Harness Handbook(Harness 手册):一种通过静态分析与 LLM 辅助结构化从 Harness 代码库中自动合成的以行为为中心的表征,它将每种行为与其对应的源码进行了关联。
我们还提出了 行为引导渐进式揭示(Behavior-Guided Progressive Disclosure, BGPD) 机制,该机制能够引导 Agent 从高层行为逐步深入到相关的实现细节,并根据当前源码验证候选代码位置。
在来自两个开源 Harness 的多样化修改需求测试中,基于手册辅助的规划(Handbook-Assisted planning)在减少规划器 Token 消耗的同时,提高了行为定位与修改计划的质量;其中,收益最显著的场景包括:分散的代码位置、罕见执行路径以及跨模块交互。
因此,演进复杂的 Agentic 系统不仅取决于生成修改代码,还取决于准确确定这些修改应当施加在何处。
原文链接:https://arxiv.org/abs/2607.13285
前往小宇宙评论区与主播互动
【粉丝投稿001期】HydroGym:流体力学强化学习通用平台
今天的这篇的主题是: The HydroGym reinforcement learning platform for fluid dynamics
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
流体流动的有效控制在交通运输、能源和医学领域至关重要,它可以增加升力、降低阻力、增强混合并衰减噪声¹⁻³。然而,流体控制极其困难,因为它们涉及高维、非线性和多尺度的动态特性,这些特性使得传统方法难以奏效⁴⁻⁶。强化学习在蛋白质折叠和复杂游戏等领域推动了显著的进展,这些领域拥有共享的基准测试和标准化的环境⁷⁻¹⁰。流体力学一直缺乏此类基础设施,因此每个控制器通常仅针对单一的几何形状和运行条件进行调优,导致研究进展难以积累、迁移和比较¹¹⁻¹³。
在本文中,我们推出了 HydroGym,这是一个独立于求解器的强化学习平台,提供了 60 多个经过验证且公开可用的流体控制环境。这些环境涵盖了从典范的层流到复杂的湍流,雷诺数(Reynolds number)系统性地跨越至 Re=4×10⁵,并包含二维和三维空间中的马赫数(Mach number)变化。
在这些环境中,Agent(智能体)重复发现了稳健的控制原理,包括边界层操控、声学反馈中断以及湍流尾流重构。至关重要的是,我们展示了零样本迁移(zero-shot transfer)的概念验证:仅在低成本替代环境中训练的 Agent 被直接部署到具挑战性的真实场景中(如三维翼型截面)。在与直接在翼型上进行优化的方案相比时,我们在将探索成本降低四个数量级的同时,实现了局部皮细摩擦力(skin friction)38% 的降低。由于这种迁移利用了共享的近壁面物理特性,其泛化的广度仍有探索空间,这为跨越计算成本高昂的模拟环境开展策略泛化研究提供了一条全新路径。通过提供一个通用且具扩展性的可复现研究基础,HydroGym 将流体控制研究从孤立的个案研究推向了凝聚的社区合作努力。
原文链接:https://www.nature.com/articles/s41586-026-10917-6
前往小宇宙评论区与主播互动
【第714期】ProxyMark:基于代理陷阱与流量水印的门罗币Tor节点去匿名化研究
今天的这篇的主题是:Deanonymizing Monero Transactions in Tor Network
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:seventy3_podcast(加群/投稿论文)
Summary
Monero(门罗币)是一种注重隐私的加密货币,它部署了 Dandelion++ 协议并集成了匿名网络(如 Tor 和 I2P),以防止恶意攻击者将交易与其源 IP 地址关联起来。在本文中,我们证明了 Monero 对 Tor 网络的集成引入了一个根本性的漏洞:Monero Tor 节点发起的交易在进入明网(clearnet)传播之前,会排他性地转发给两个出站 Tor 隐蔽服务节点(代理节点);这使得攻击者能够通过占据目标节点的出站连接来捕获其发起的交易。
基于这一发现,我们提出了 ProxyMark——一个针对 Monero Tor 网络的威胁拓扑三阶段去匿名化框架,包含:
节点角色识别
源发起交易识别
节点位置去匿名化
通过在 live Tor 网络、Monero 主网和测试网上的实验,我们从实证角度证明了 ProxyMark 在成功去匿名化经由 Tor 发起的 Monero 节点交易方面的有效性。
原文链接:https://arxiv.org/abs/2607.07062
前往小宇宙评论区与主播互动
【第713期】LingBot-World-Infinity:无限交互式现实世界模拟器
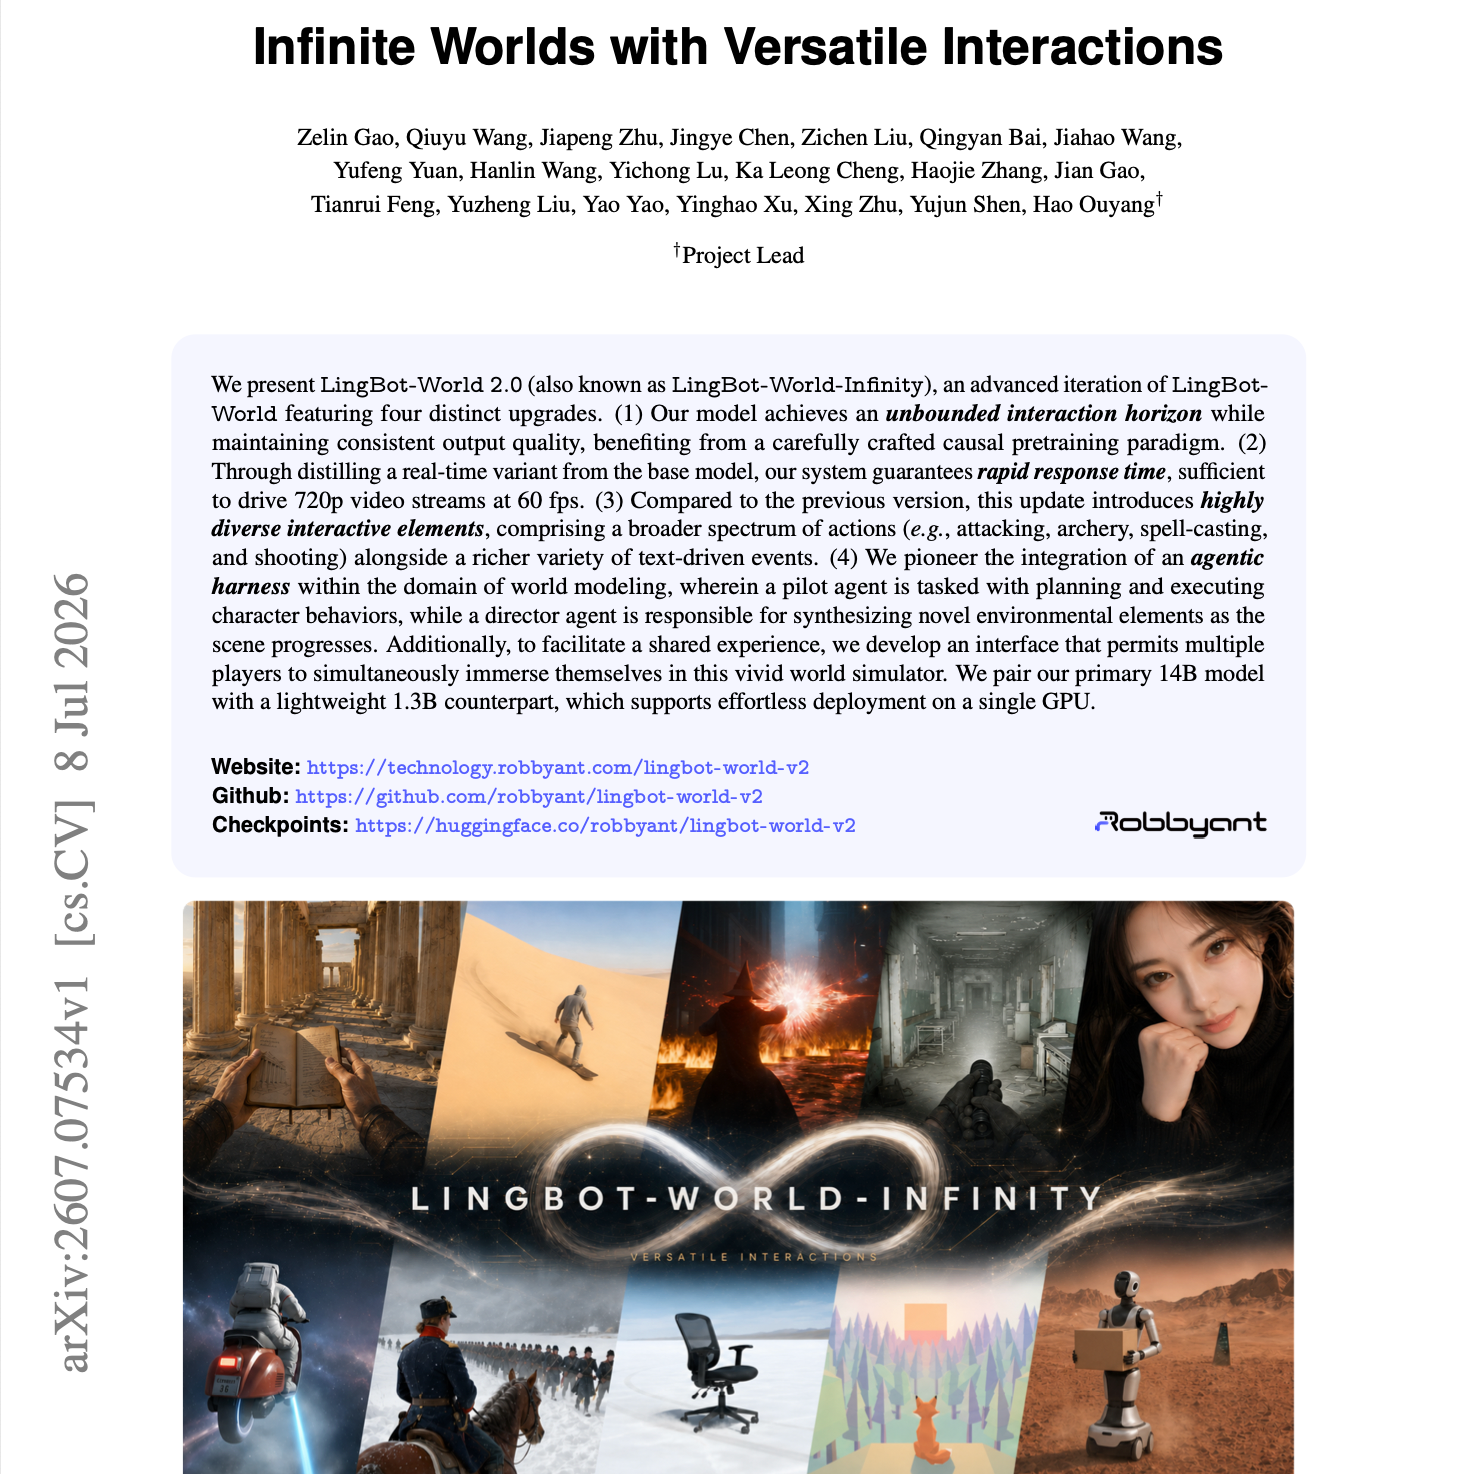
今天的这篇的主题是:Infinite Worlds with Versatile Interactions
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:seventy3_podcast(加群/投稿论文)
Summary
我们推出了 LingBot-World 2.0(亦称 LingBot-World-Infinity),这是 LingBot-World 的高级迭代版本,带来四大显著升级:
无界交互视角/时长:得益于精心设计的因果预训练范式(causal pretraining paradigm),我们的模型在保持输出质量一致性的同时,实现了无限延展的交互时长。
实时流化响应:通过从基座模型蒸馏出一个实时变体,系统保证了极快的响应速度,足以驱动 60 fps 的 720p 视频流。
丰富交互元素:与上一版本相比,本次更新引入了高度多样化的交互元素,涵盖更广泛的动作形态(如攻击、拉弓射箭、施法和射击),以及种类更丰富的文本驱动事件。
Agentic Harness 编排框架:我们开创性地将 Agent 治理框架(agentic harness)引入世界建模(world modeling)领域——其中,驾驶员 Agent(pilot agent)负责规划并执行角色行为,而导演 Agent(director agent)则负责随着场景的推进合成全新的环境元素。
此外,为了便于多人共享体验,我们开发了一个支持多名玩家同时沉浸于这一生动世界模拟器中的交互接口。我们还将主力的 14B 模型与轻量化的 1.3B 模型进行搭配,后者支持在单张 GPU 上进行轻松部署。
原文链接:https://arxiv.org/abs/2607.07534
前往小宇宙评论区与主播互动
【第712期】失败的演进:CLI编程智能体执行轨迹剖析
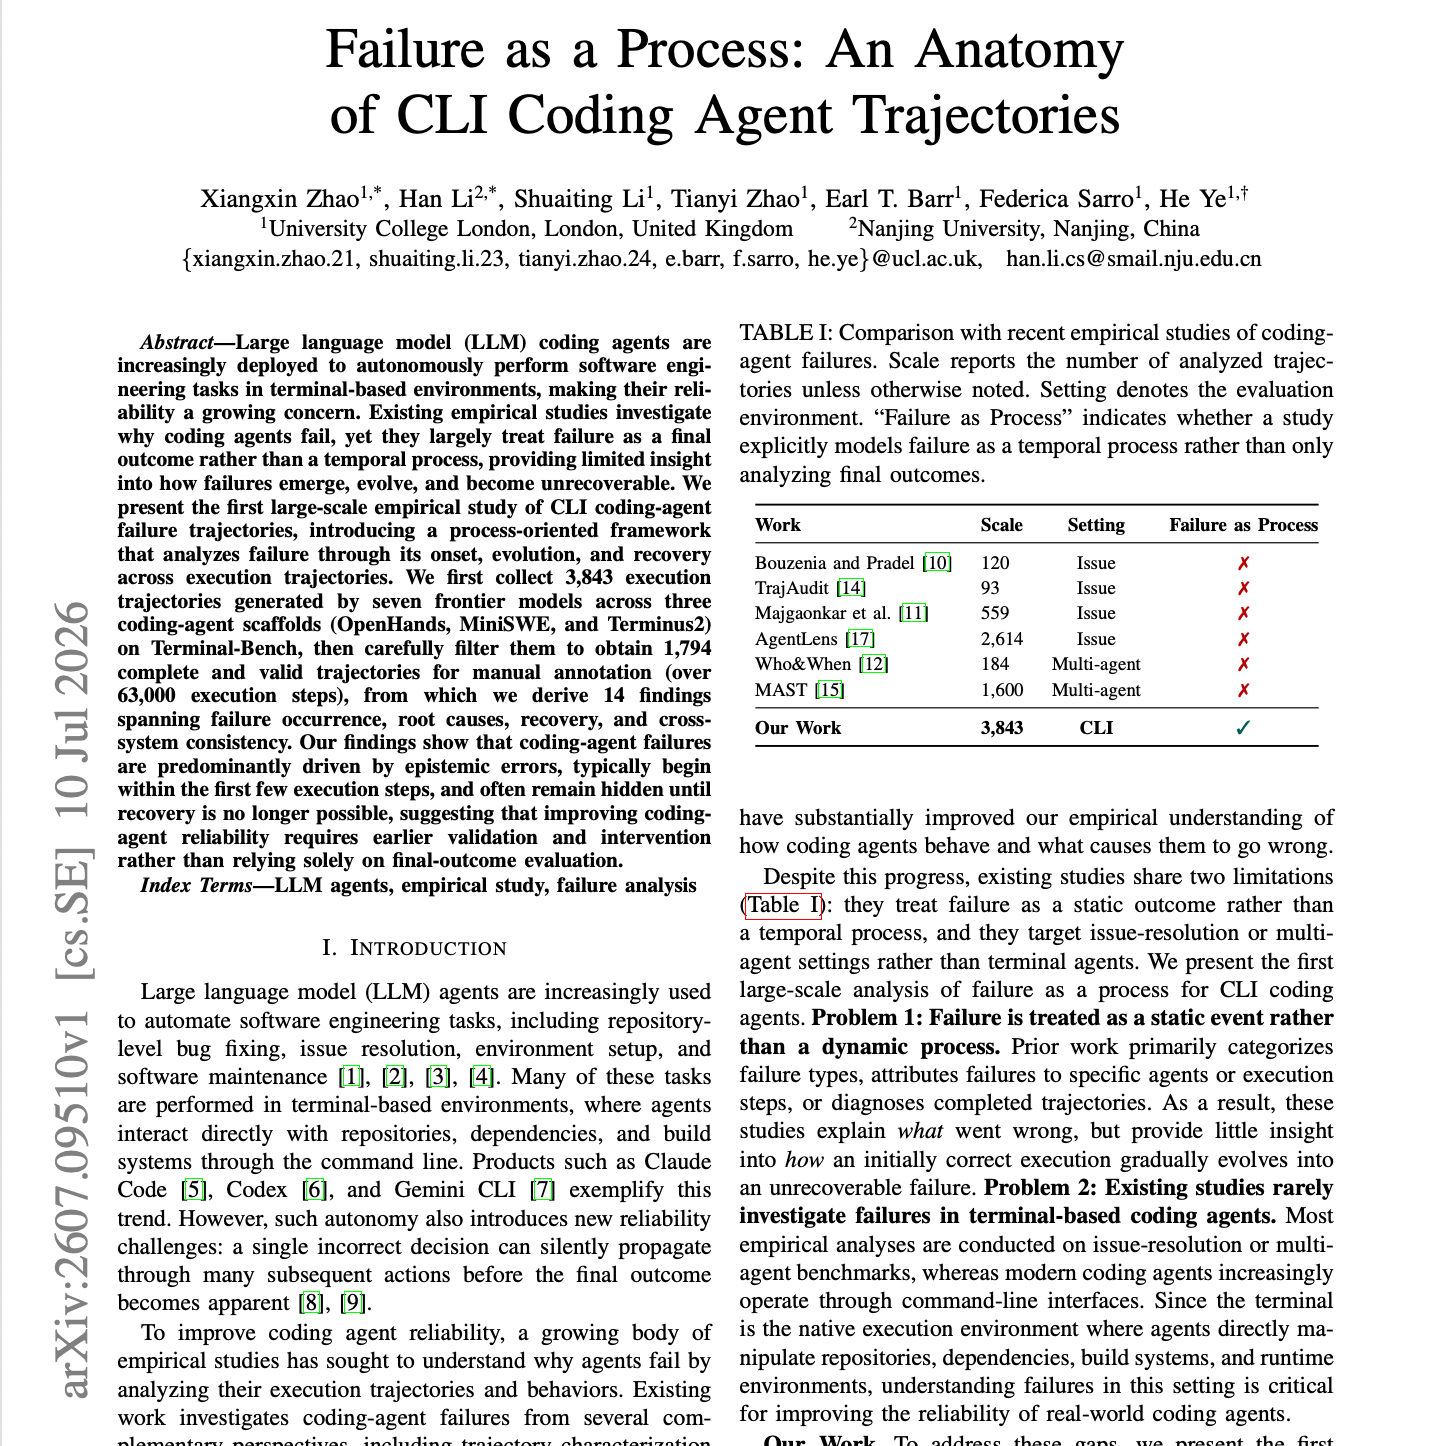
今天的这篇的主题是:Failure as a Process: An Anatomy of CLI Coding Agent Trajectories
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:seventy3_podcast(加群/投稿论文)
Summary
大语言模型(LLM)编码 Agent(Coding agents)正越来越多地被部署于终端环境中自动执行软件工程任务,这使得它们的可靠性成为一个日益受关注的问题。现有的实证研究虽然探讨了编码 Agent 发生失败的原因,但大多将“失败”视为一种最终结果而非一个时序过程,对于失败如何萌生、演化并最终变得不可逆转所提供的见解非常有限。
本文展示了首个关于命令行(CLI)编码 Agent 失败轨迹的大规模实证研究,提出了一个面向过程的框架(process-oriented framework),通过执行轨迹中的萌生(onset)、演化(evolution)和恢复(recovery)三个阶段来分析失败。
我们首先收集了由 7 个前沿模型在 3 个编码 Agent 支架(OpenHands、MiniSWE 和 Terminus2)上于 Terminal-Bench 产生的 3,843 条执行轨迹;随后对其进行细致筛选,提取出 1,794 条完整且有效的轨迹用于人工标注(包含超过 63,000 个执行步骤);并从中推导出了涵盖失败发生率、根本原因、恢复机制以及跨系统一致性等方面的 14 项研究发现。
我们的研究结果表明:
编码 Agent 的失败主要是由认知错误(epistemic errors)驱动的;
失败通常在最初的几个执行步骤内就已开始萌生;
失败往往处于隐蔽状态,直到再也无法恢复时才暴露出来。
这表明,要提升编码 Agent 的可靠性,需要更早地进行验证与干预,而不是仅仅依赖最终结果的评估。
原文链接:https://arxiv.org/abs/2607.09510
前往小宇宙评论区与主播互动
【第711期】OAT:基于单类学习的智能体故障追溯
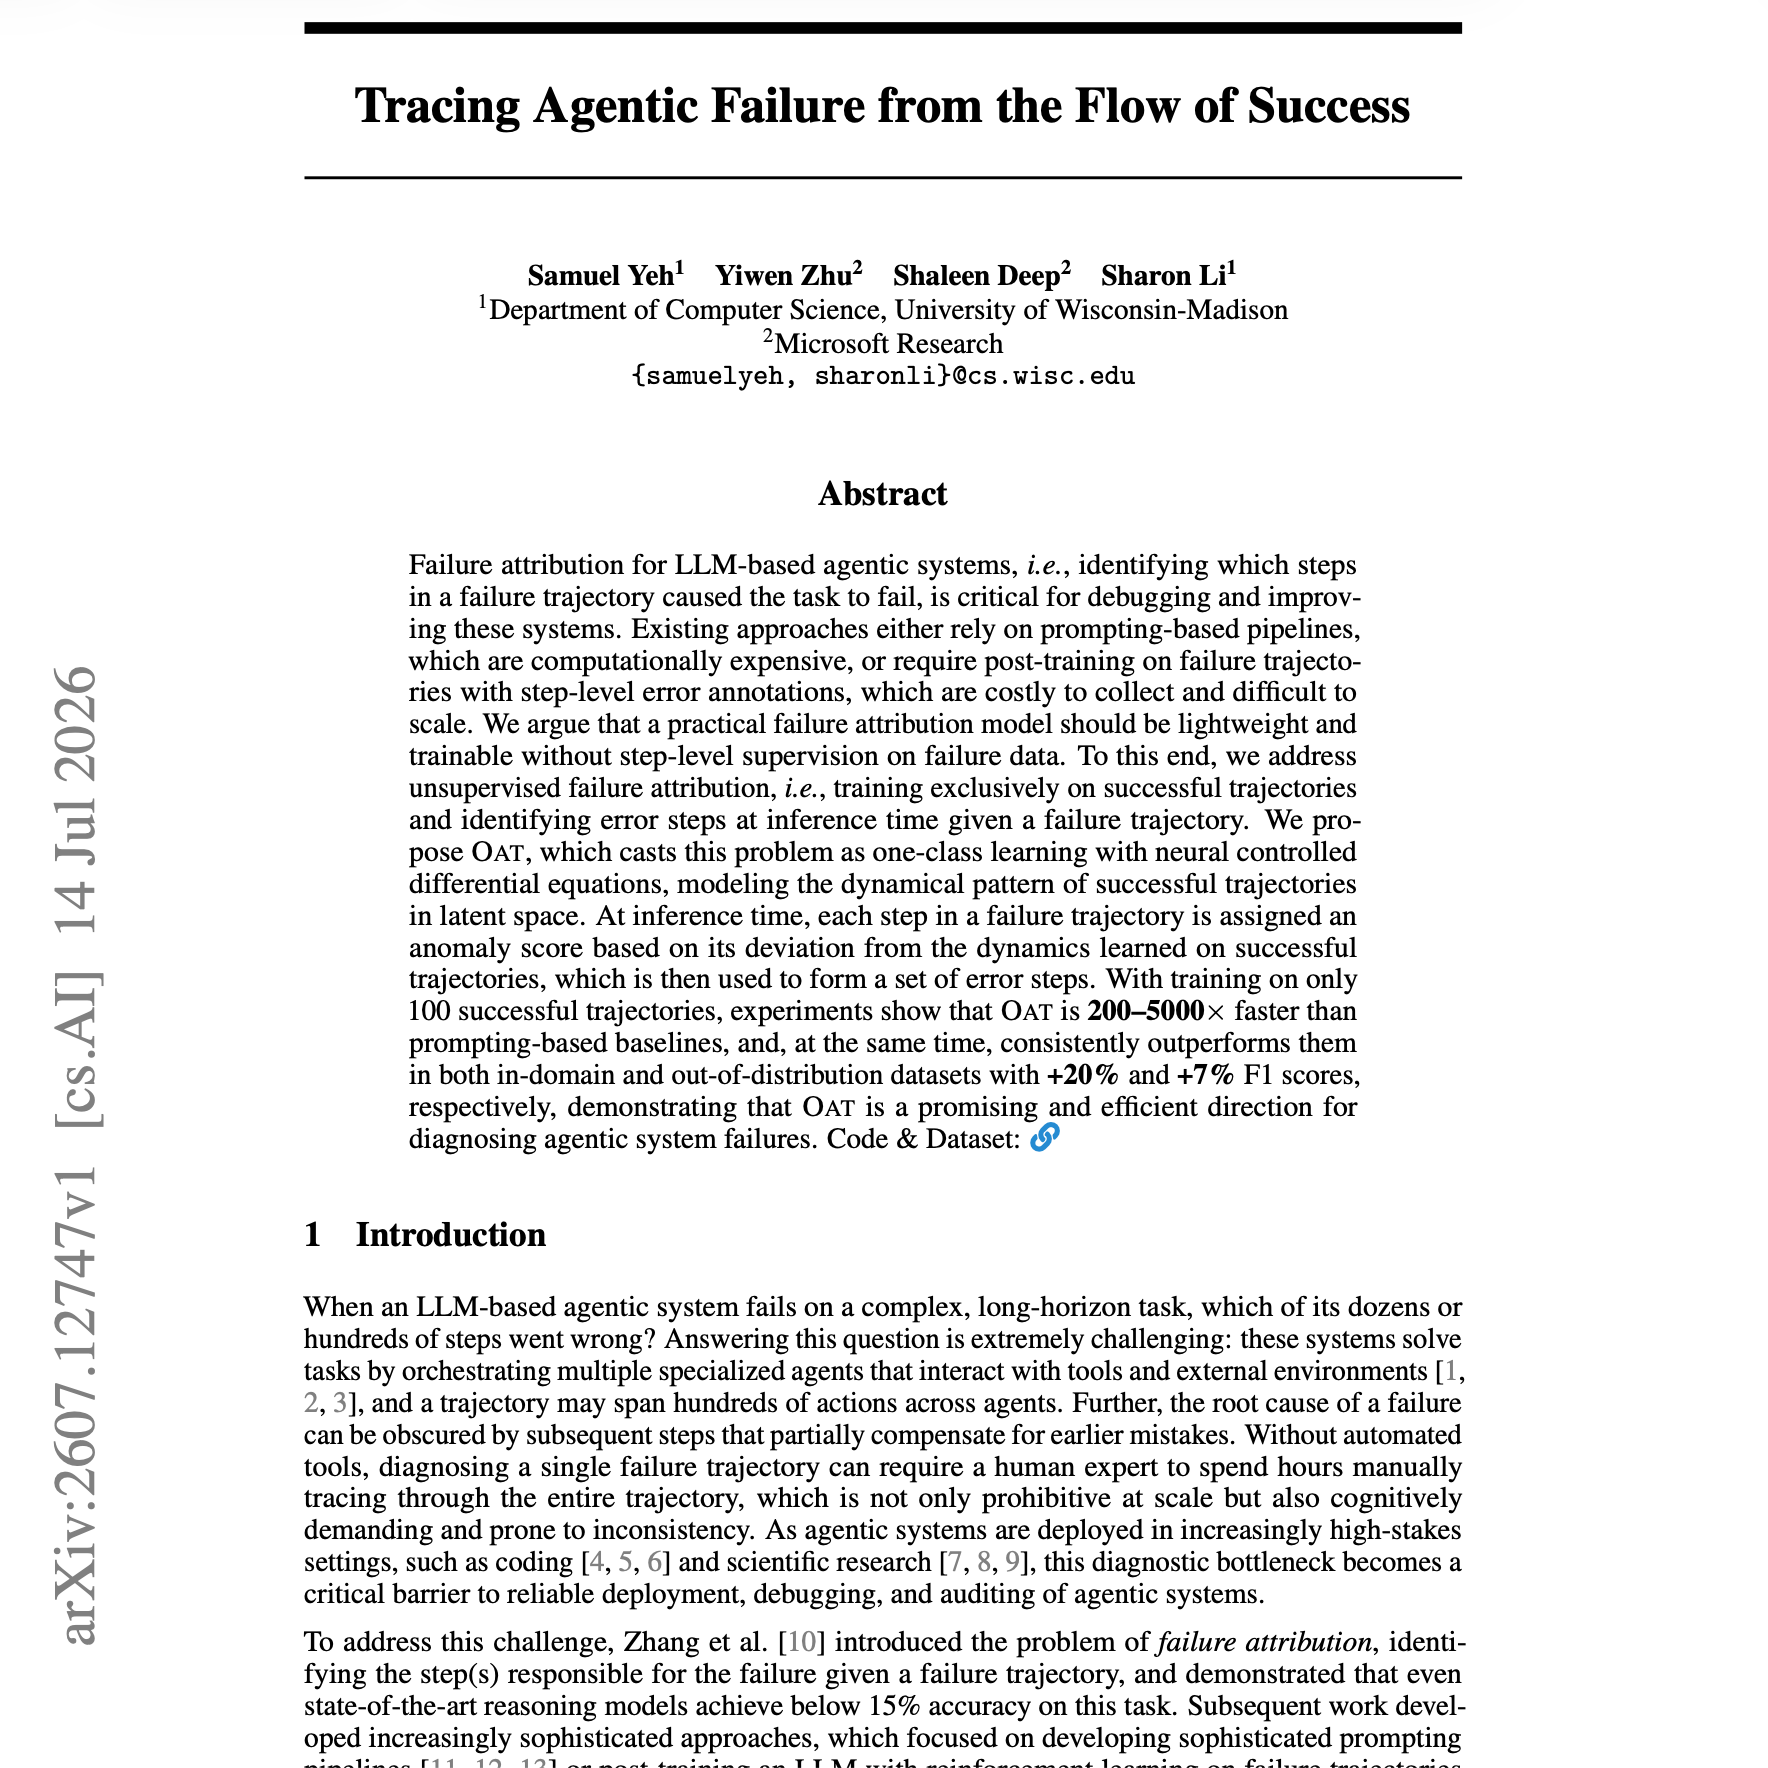
今天的这篇的主题是:Tracing Agentic Failure from the Flow of Success
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:seventy3_podcast(加群/投稿论文)
Summary
针对基于 LLM 的 Agentic 系统(智能体系统)进行失效归因(failure attribution)——即确定失效轨迹中哪些步骤导致了任务失败——对于调试和改进此类系统至关重要。现有的方法要么依赖基于 Prompt 提示的管线(计算成本高昂),要么需要在带有步骤级错误标注的失效轨迹上进行后训练(这类标注收集成本高且难以扩展)。
我们认为,一个实用的失效归因模型应当是轻量化的,且无需对失效数据进行步骤级监督即可训练。为此,我们探讨了无监督失效归因:即仅在成功轨迹上进行训练,并在推理阶段给定一条失效轨迹时识别出错误步骤。
我们提出了 OAT,该方法将这一问题转化为了基于神经网络控制微分方程(neural controlled differential equations)的单类学习(one-class learning),在隐空间(latent space)中对成功轨迹的动态模式进行建模。在推理阶段,失效轨迹中的每一个步骤都会根据其偏离在成功轨迹上学到的动态模式的程度被赋予一个异常得分,进而用其构建出错误步骤集合。
实验表明,仅在 100 条成功轨迹上进行训练,OAT 即可实现比基于 Prompt 提示的基线快 200 至 5000 倍 的推理速度;同时,在域内(in-domain)和分布外(out-of-distribution)数据集上均持续超越基线,F1 分数分别提升了 +20% 和 +7%。这表明 OAT 为诊断 Agentic 系统失效提供了一个极具前景且高效的方向。
原文链接:https://arxiv.org/abs/2607.12747
前往小宇宙评论区与主播互动